
Vetorize os seus dados sem esforço com o 4D Embedding Studio
Novembro 13, 2026
9 Tempo de leitura
As representações vetoriais abrem caminho para muitos casos de utilização da IA nas suas aplicações 4D: pesquisa semântica, recomendações, correspondência de conteúdos e classificação de documentos.
No entanto, criar uma embedding envolve mais do que apenas gerar um vetor. À medida que os seus dados mudam, as respetivas representações vetoriais também têm de ser atualizadas. É necessário detetar alterações, invalidar os vetores afetados, recalculá-los e lidar com potenciais erros ou limitações dos serviços de IA.
A partir do 4D 21 R5, o « 4D Embedding Studio » poupa-lhe o trabalho de construir toda esta infraestrutura. Uma interface permite-lhe configurar as suas embeddings, enquanto o agendador gere o seu ciclo de vida, desde a invalidação até ao recálculo. Isto permite-lhe concentrar-se no que importa: utilizar embeddings para integrar funcionalidades de IA nas suas aplicações.
Neste HDI, os recálculos são acionados manualmente para que possa observar cada passo e obter resultados imediatamente. O agendador, que automatiza este processo em produção, é explicado mais adiante neste artigo.
Uma incorporação é uma representação vetorial de conteúdo. Transforma texto ou outras informações numa sequência de números que um modelo de IA pode comparar. Como resultado, conteúdos com significados semelhantes produzem vetores semelhantes, mesmo quando não utilizam exatamente as mesmas palavras.
Com o 4D Embedding Studio, pode configurar a geração de embeddings inteiramente através da interface:
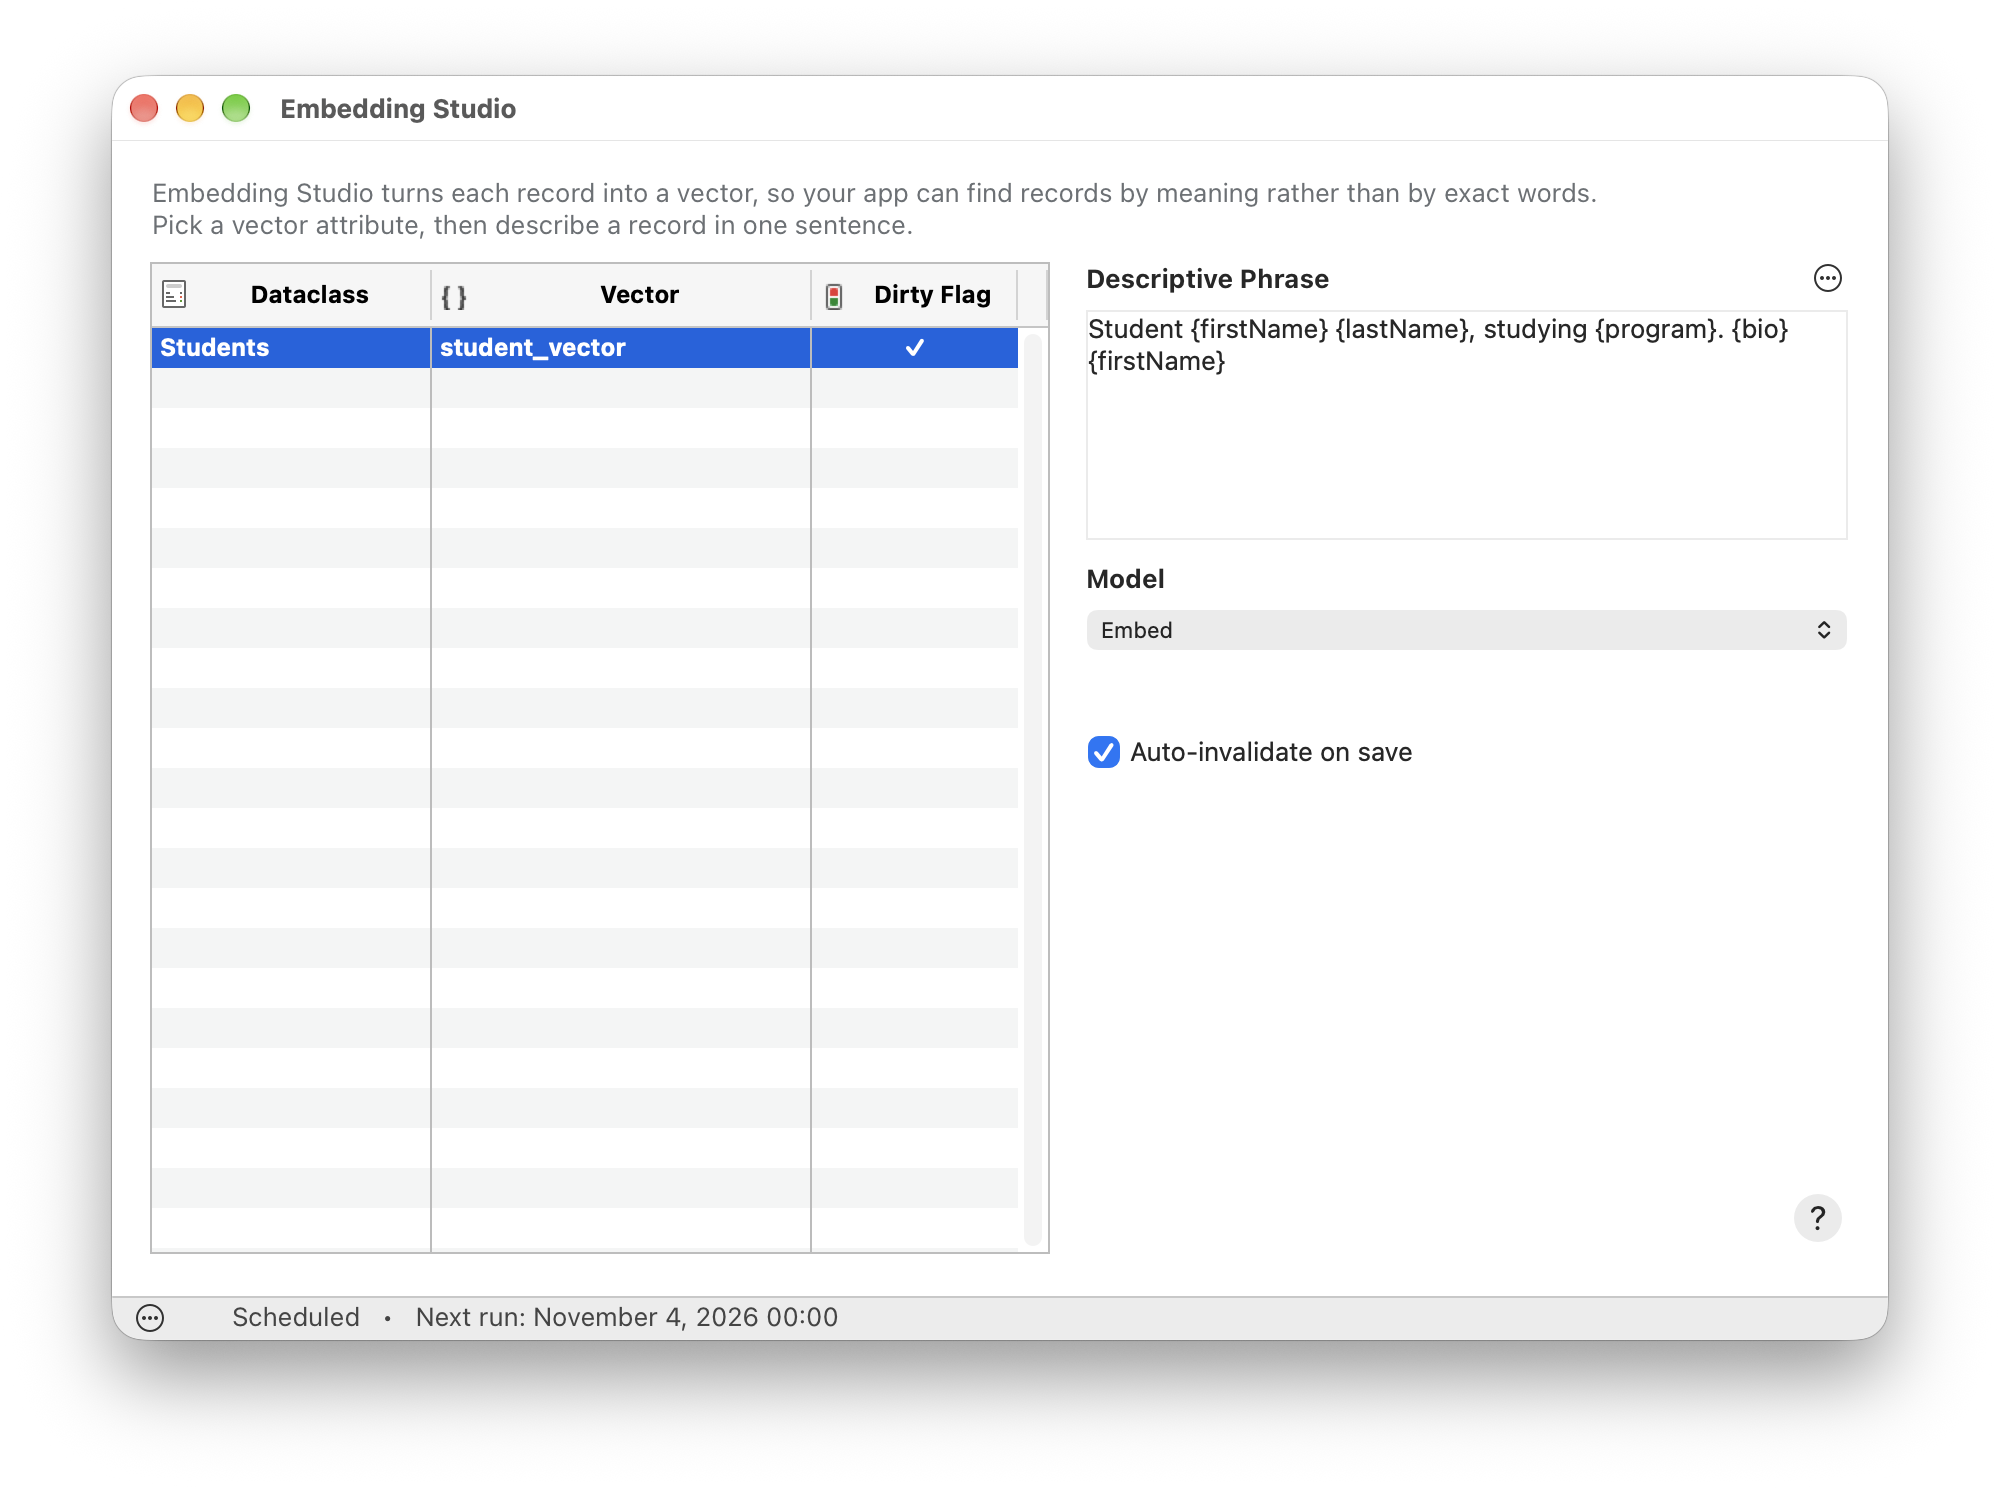
E já está. Não precisa de escrever a lógica que gera os vetores. O 4D sabe como construir a incorporação a partir da sua configuração.
Os seus vetores estão agora prontos a ser utilizados na sua aplicação, por exemplo, para realizar pesquisas semânticas.
Numa aplicação em produção, os dados nunca são estáticos. Se uma incorporação se basear no título e no conteúdo de um documento, qualquer alteração em qualquer um deles deve ser tida em conta.
Sem um mecanismo dedicado, tem duas estratégias possíveis, nenhuma das quais é ideal:
O 4D Embedding Studio adota uma abordagem mais direcionada. Quando uma entidade é modificada, o 4D determina se a alteração afeta a composição da sua incorporação. Apenas os vetores afetados são invalidados e marcados para recálculo.
Não é necessário desenvolver nem manter a sua própria lógica de deteção de alterações.
Nota: a deteção aplica-se aos campos da própria tabela. Se o conteúdo da incorporação utilizar um atributo de uma tabela relacionada, um atributo calculado, um alias ou uma propriedade de um objeto, a sua alteração não invalida automaticamente o vetor. Nesse caso, invalide os vetores programaticamente ou force o seu recálculo.
Quando uma alteração exige que uma incorporação seja atualizada, o 4D Embedding Studio permite-lhe escolher como o vetor deve ser marcado como desatualizado.
Se não estiver definido nenhum campo de rastreio, um vetor invalidado é automaticamente substituído por Null. Por conseguinte, deixa de ser utilizado nas pesquisas até ser calculado novamente.
Esta opção funciona bem para aplicações que dão prioridade a uma consistência rigorosa: é melhor não devolver resultados do que basear-se numa incorporação que já não corresponde aos dados atuais.
Também é possível adicionar um campo booleano denominado « <vector_name>_dirty » à estrutura. Quando é necessária uma atualização, este campo é definido como «true» e o vetor existente é mantido até ser recalculado.
A sua aplicação pode então optar por continuar a utilizar este vetor temporariamente ou excluí-lo, filtrando por «<vector_name>_dirty = false».
Esta estratégia garante a continuidade do serviço, permitindo-lhe identificar exatamente quais os vetores que estão a aguardar ser recalculados.
A alteração do modelo é um caso especial: modelos diferentes produzem vetores que não podem ser comparados entre si. Após uma alteração de modelo, todos os vetores devem, portanto, ser recalculados, e o 4D Embedding Studio marca automaticamente todos os registos afetados como «dirty». Até serem recalculados, exclua-os das suas pesquisas com o filtro «<vector_name>_dirty =false».
Se a sua lógica de negócio exigir controlo total, também pode desativar a invalidação automática e gerir este ciclo de vida por si próprio.
Assim que os vetores forem marcados como desatualizados, o seu recálculo é gerido pelo agendador do 4D Embedding Studio. Basta escolher a frequência com que deve ser executado e, em seguida, iniciá-lo: quer ativando a opção «Executar o método ‘On Host Database Event’ dos componentes» nas Definições de Estrutura, na página Segurança (desativada por predefinição), quer com uma única linha de código:
cs.EmbeddingStudio.Scheduler.me.start()O 4D Embedding Studio orquestra então o processamento por si.
Os recálculos são executados de forma assíncrona, sem bloquear os utilizadores. Pode ajustar a sua frequência de acordo com as necessidades da sua aplicação: execute-os regularmente, em atualizações em lote ou acione-os quando necessário, por exemplo, após uma implementação ou uma alteração significativa nos seus dados.
Um erro não interrompe o processamento: os vetores que não puderam ser calculados permanecem pendentes e são automaticamente tentados novamente durante a próxima execução.
Isto permite-lhe encontrar o equilíbrio certo entre resultados atualizados, carga de processamento e custos da API de IA, enquanto a 4D trata dos mecanismos necessários para recalcular as suas incorporações.
Depois de os seus vetores terem sido calculados, a pesquisa semântica decorre em duas etapas.
Primeiro, calcule uma embedding para o texto introduzido pelo utilizador. Para que os vetores sejam comparáveis, esta deve ser calculada com o mesmo modelo que os vetores armazenados. Utilizar a definição configurada no 4D Embedding Studio garante que utiliza a definição correta.
// Retrieve the embedding definition configured in 4D Embedding Studio
var $settings:=cs.EmbeddingStudio.Settings.new()
var $definition:=$settings.find("Students"; "student_vector")

// Compute the vector of the user's query with the same model
var $result:=cs.EmbeddingStudio.Playground.new().embed("apps that are easy to use"; $definition)
Em seguida, execute uma consulta ORDA no campo de vetores. O 4D compara nativamente o vetor da consulta com os das suas entidades, mantém aqueles que excedem o limiar de similaridade e ordena-os do mais próximo ao mais distante:
// Find the most similar students, best match first
var $students:=ds.Students.query("student_vector > :1 order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Se utilizar um campo «dirty», basta adicionar um critério para excluir os vetores que estão a aguardar ser recalculados:
var $students:=ds.Students.query("student_vector > :1 and student_vector_dirty = false order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Esta pesquisa permite encontrar um aluno cuja biografia mencione «interfaces intuitivas» e «testes de usabilidade», mesmo que nenhuma dessas palavras apareça na consulta.
Para saber mais sobre a pesquisa vetorial no 4D (métricas de semelhança, limiares e como combiná-la com critérios tradicionais), consulte os nossos artigos anteriores:
Agora que já tem tudo o que precisa para começar, porque não experimentar o 4D Embedding Studio na sua própria aplicação? Primeiro, adicione-o ao seu projeto: abra «Design > Dependências do projeto», clique no botão «+» e selecione o separador «GitHub». Escolha «4D Embedding Studio» na lista de componentes 4D padrão e, em seguida, adicione-o ao seu projeto.
A regra de dependência está definida como «Seguir a versão 4D» por predefinição, mantendo o componente alinhado com a sua versão do 4D. Reinicie o seu projeto quando solicitado a carregar o componente.
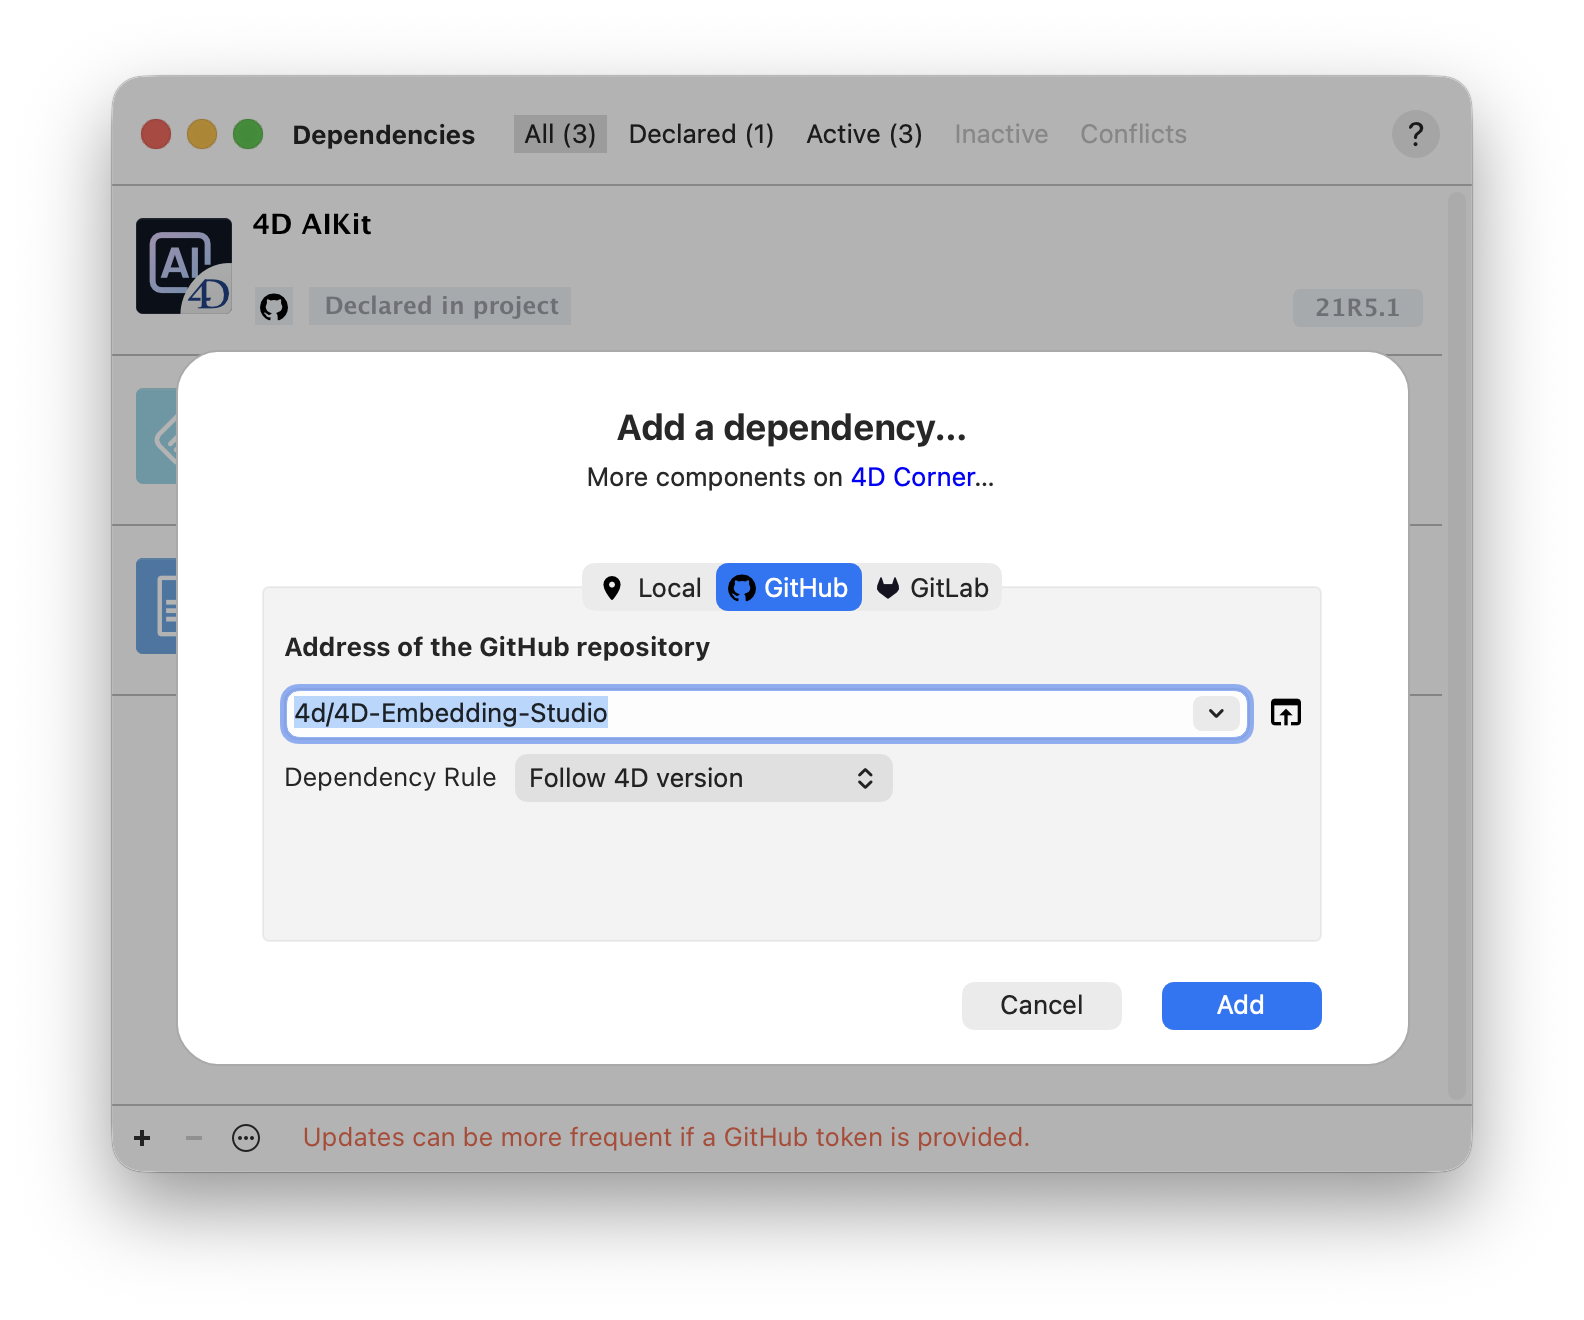
Para mais informações, consulte «Gerir dependências do projeto » e «Controlar os componentes padrão do 4D».
Com o 4D Embedding Studio, a 4D trata de todos os aspetos técnicos necessários para o ciclo de vida das suas integrações:
Não há necessidade de criar nem manter esta infraestrutura: o seu código pode concentrar-se no que acrescenta valor à sua aplicação, como a pesquisa semântica, as recomendações ou a correspondência de conteúdos.
Consulte a documentação para configurar a sua primeira incorporação e saber como integrá-la nas suas pesquisas semânticas.
Tem uma pergunta, sugestão ou apenas quer entrar em contacto com os bloggers 4D? Deixe-nos uma linha!
* A sua privacidade é muito importante para nós. Por favor clique aqui para ver os nossos Política
De momento, não é possível deixar comentários nesta publicação.