
Vektorisieren Sie Ihre Daten mühelos mit 4D Embedding Studio
November 13, 2026
9 Lesezeit
Einbettungen eröffnen zahlreiche Anwendungsmöglichkeiten für KI in Ihren 4D-Anwendungen: semantische Suche, Empfehlungen, Inhaltsabgleich und Dokumentenklassifizierung.
Das Erstellen eines Embeddings umfasst jedoch mehr als nur die Generierung eines Vektors. Wenn sich Ihre Daten ändern, müssen auch deren Vektordarstellungen aktualisiert werden. Sie müssen Änderungen erkennen, die betroffenen Vektoren ungültig machen, sie neu berechnen und potenzielle Fehler oder Einschränkungen von KI-Diensten behandeln.
Ab 4D 21 R5 erspart Ihnen „ 4D Embedding Studio “ den Aufbau dieser gesamten Infrastruktur. Über eine Schnittstelle können Sie Ihre Embeddings konfigurieren, während der Scheduler deren Lebenszyklus verwaltet – von der Ungültigmachung bis zur Neuberechnung. So können Sie sich auf das Wesentliche konzentrieren: die Nutzung von Embeddings, um KI-Funktionen in Ihre Anwendungen zu integrieren.
In diesem HDI werden die Neuberechnungen manuell ausgelöst, sodass Sie jeden Schritt beobachten und sofort Ergebnisse erhalten können. Der Scheduler, der diesen Prozess in der Produktion automatisiert, wird später in diesem Artikel erläutert.
Ein Embedding ist eine vektorielle Darstellung von Inhalten. Es wandelt Text oder andere Informationen in eine Zahlenfolge um, die ein KI-Modell vergleichen kann. Dadurch erzeugen Inhalte mit ähnlicher Bedeutung ähnliche Vektoren, auch wenn sie nicht genau dieselben Wörter verwenden.
Mit 4D Embedding Studio können Sie die Erzeugung von Embeddings vollständig über die Benutzeroberfläche konfigurieren:
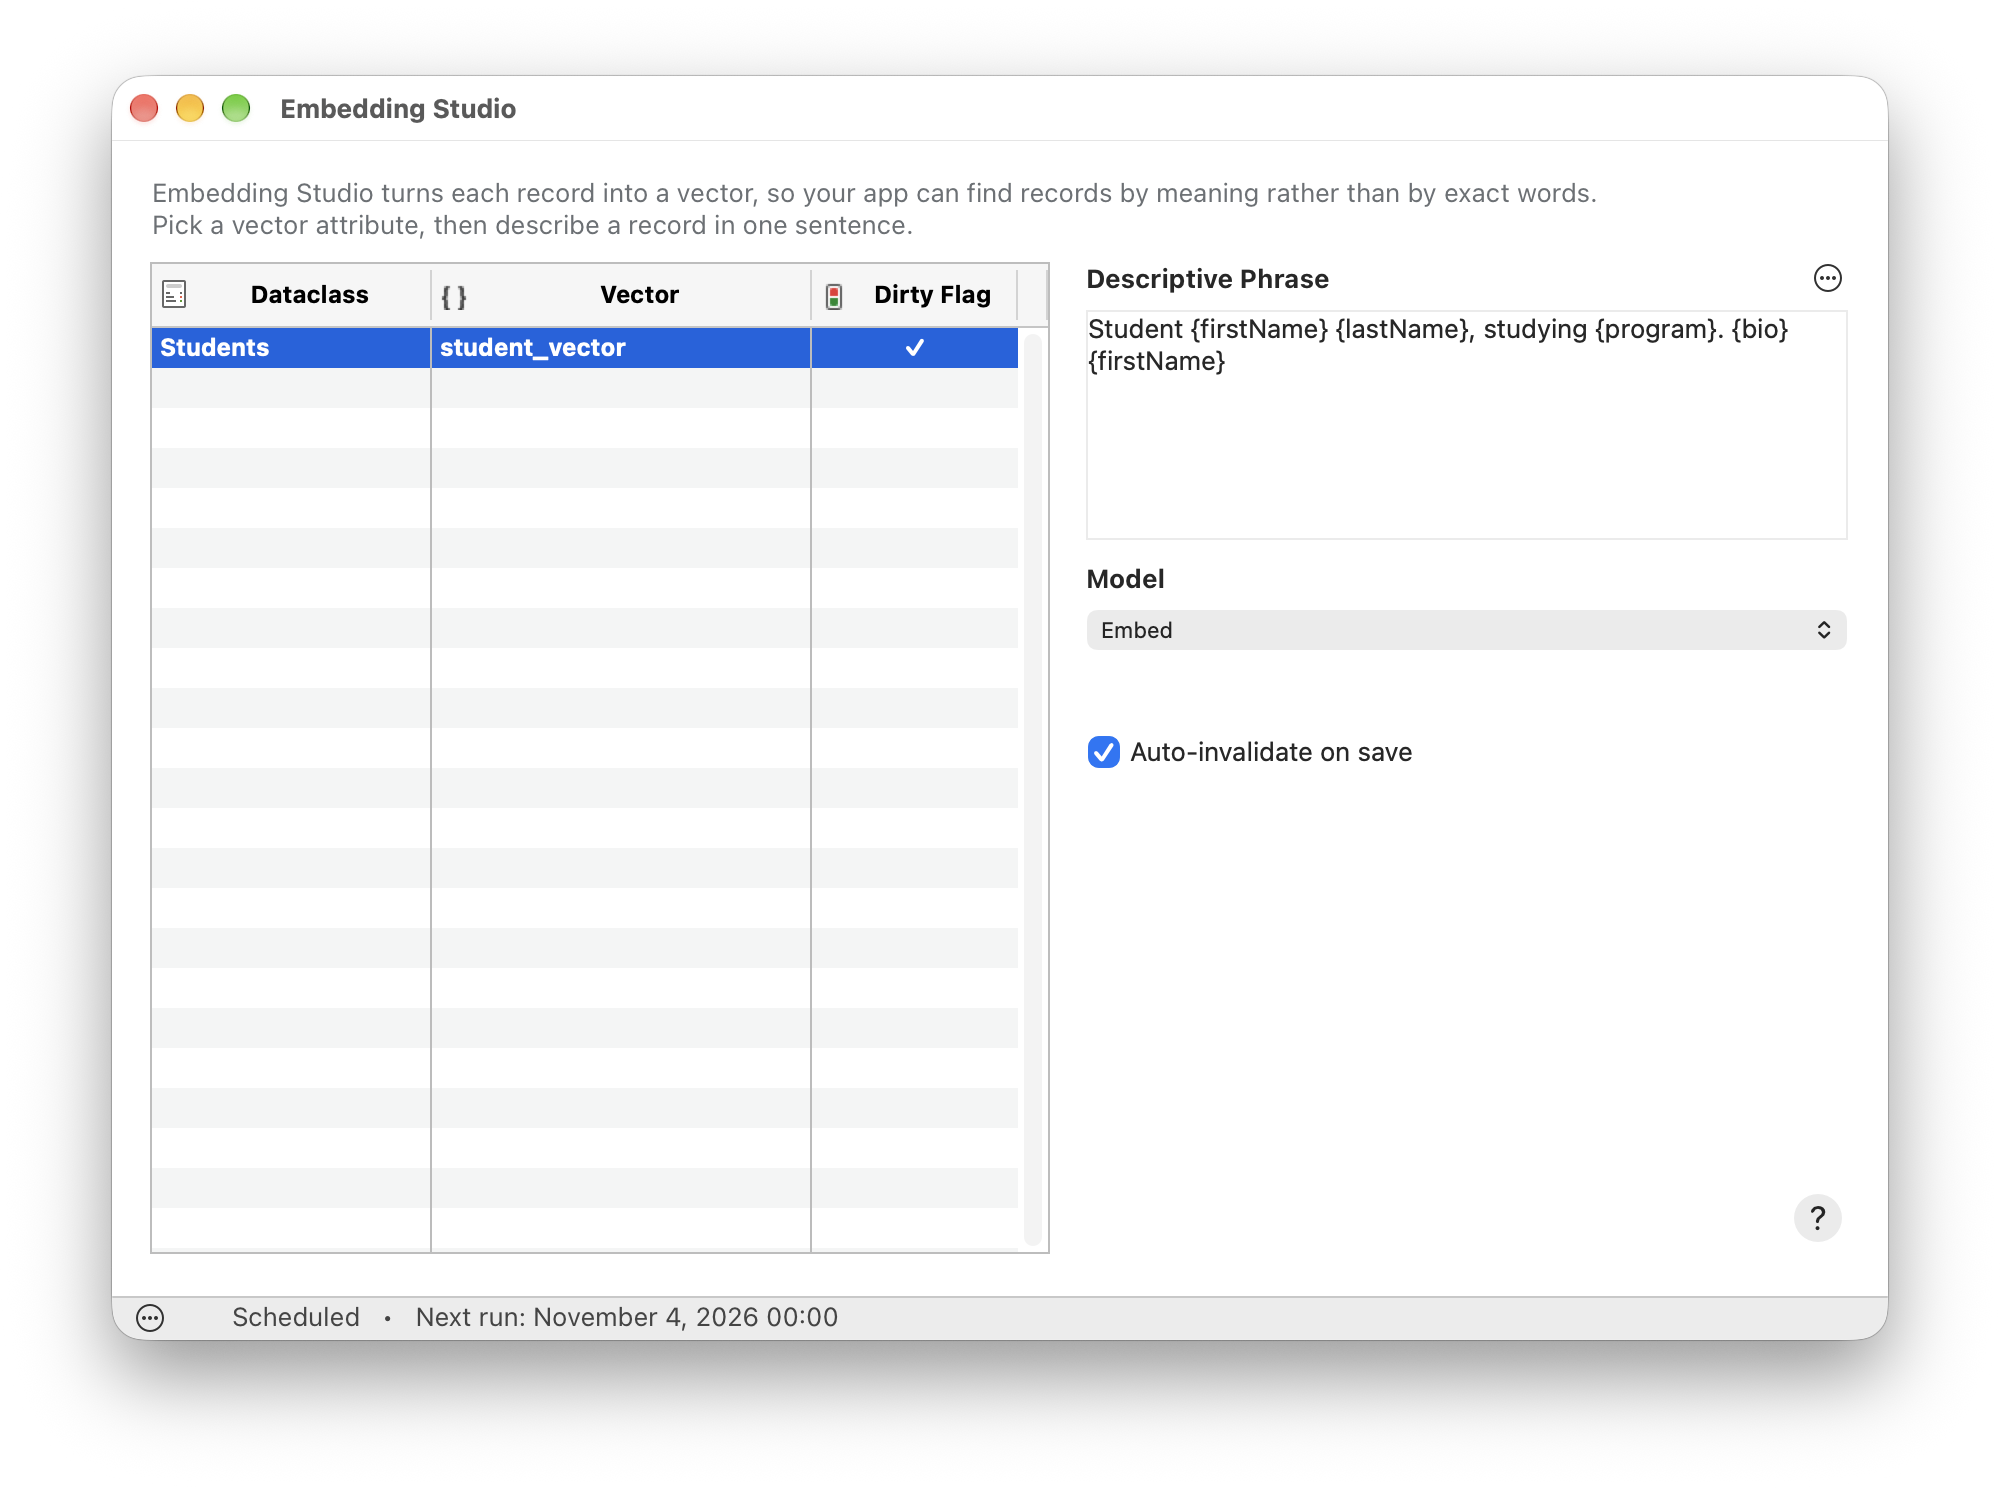
Das war’s schon. Sie müssen keine Logik schreiben, die die Vektoren generiert. 4D weiß anhand Ihrer Konfiguration, wie die Einbettung aufgebaut werden muss.
Ihre Vektoren stehen nun in Ihrer Anwendung zur Verfügung, beispielsweise zur Durchführung semantischer Suchen.
In einer Produktionsanwendung sind Daten niemals statisch. Wenn eine Einbettung auf dem Titel und dem Inhalt eines Dokuments basiert, muss jede Änderung an einem der beiden berücksichtigt werden.
Ohne einen speziellen Mechanismus haben Sie zwei mögliche Strategien, von denen keine ideal ist:
4D Embedding Studio verfolgt einen gezielteren Ansatz. Wenn eine Entität geändert wird, ermittelt 4D, ob sich die Änderung auf die Zusammensetzung ihrer Einbettung auswirkt. Nur die betroffenen Vektoren werden ungültig gemacht und zur Neuberechnung markiert.
Sie müssen keine eigene Logik zur Änderungserkennung entwickeln oder pflegen.
Hinweis: Die Erkennung gilt für Felder in der Tabelle selbst. Wenn der Einbettungsinhalt ein Attribut aus einer verknüpften Tabelle, ein berechnetes Attribut, einen Alias oder eine Eigenschaft eines Objekts verwendet, führt eine Änderung nicht automatisch zur Ungültigmachung des Vektors. In diesem Fall müssen Sie Vektoren programmgesteuert ungültig machen oder ihre Neuberechnung erzwingen.
Wenn eine Änderung eine Aktualisierung der Einbettung erfordert, können Sie in 4D Embedding Studio festlegen, wie der Vektor als veraltet markiert werden soll.
Wenn kein Tracking-Feld definiert ist, wird ein ungültig gemachter Vektor automatisch durch „Null“ ersetzt. Er wird daher bei Suchvorgängen nicht mehr verwendet, bis er erneut berechnet wird.
Diese Option eignet sich gut für Anwendungen, bei denen strenge Konsistenz Priorität hat: Es ist besser, keine Ergebnisse zurückzugeben, als sich auf eine Einbettung zu verlassen, die nicht mehr mit den aktuellen Daten übereinstimmt.
Sie können der Struktur auch ein boolesches Feld namens „ <vector_name>_dirty “ hinzufügen. Wenn eine Aktualisierung erforderlich ist, wird dieses Feld auf „true“ gesetzt und der vorhandene Vektor beibehalten, bis er neu berechnet wird.
Ihre Anwendung kann dann entscheiden, diesen Vektor vorübergehend weiter zu verwenden oder ihn durch Filtern nach „<vector_name>_dirty = false“ auszuschließen.
Diese Strategie gewährleistet die Kontinuität des Dienstes und ermöglicht es Ihnen gleichzeitig, genau zu erkennen, welche Vektoren auf eine Neuberechnung warten.
Die Änderung des Modells stellt einen Sonderfall dar: Verschiedene Modelle erzeugen Vektoren, die nicht miteinander verglichen werden können. Nach einer Modelländerung müssen daher alle Vektoren neu berechnet werden, und 4D Embedding Studio markiert automatisch alle betroffenen Datensätze als „dirty“. Schließen Sie diese bis zu ihrer Neuberechnung mit dem Filter „<vector_name>_dirty =false“ von Ihren Suchvorgängen aus.
Wenn Ihre Geschäftslogik vollständige Kontrolle erfordert, können Sie die automatische Ungültigkeitserklärung auch deaktivieren und diesen Lebenszyklus selbst verwalten.
Sobald Vektoren als veraltet markiert sind, wird ihre Neuberechnung vom 4D Embedding Studio-Scheduler übernommen. Wählen Sie einfach aus, wie oft er ausgeführt werden soll, und starten Sie ihn dann: entweder durch Aktivieren der Option „Die Methode ‚On Host Database Event‘ von Komponenten ausführen“ in den Struktureinstellungen auf der Seite „Sicherheit“ (standardmäßig deaktiviert) oder mit einer einzigen Codezeile:
cs.EmbeddingStudio.Scheduler.me.start()4D Embedding Studio koordiniert dann die Verarbeitung für Sie.
Die Neuberechnungen laufen asynchron ab, ohne die Benutzer zu blockieren. Sie können ihre Häufigkeit an die Anforderungen Ihrer Anwendung anpassen: Führen Sie sie regelmäßig aus, führen Sie Sammelaktualisierungen durch oder lösen Sie sie bei Bedarf aus, beispielsweise nach einer Bereitstellung oder einer größeren Änderung an Ihren Daten.
Ein Fehler unterbricht die Verarbeitung nicht: Vektoren, die nicht berechnet werden konnten, bleiben ausstehend und werden beim nächsten Durchlauf automatisch erneut versucht.
So können Sie das richtige Gleichgewicht zwischen aktuellen Ergebnissen, Verarbeitungslast und KI-API-Kosten finden, während 4D die für die Neuberechnung Ihrer Embeddings erforderlichen technischen Abläufe übernimmt.
Sobald Ihre Vektoren berechnet wurden, erfolgt die semantische Suche in zwei Schritten.
Zunächst wird ein Embedding für den vom Benutzer eingegebenen Text berechnet. Damit die Vektoren vergleichbar sind, muss es mit demselben Modell berechnet werden wie die gespeicherten Vektoren. Die Verwendung der in 4D Embedding Studio konfigurierten Definition stellt sicher, dass Sie das richtige Modell verwenden.
// Retrieve the embedding definition configured in 4D Embedding Studio
var $settings:=cs.EmbeddingStudio.Settings.new()
var $definition:=$settings.find("Students"; "student_vector")

// Compute the vector of the user's query with the same model
var $result:=cs.EmbeddingStudio.Playground.new().embed("apps that are easy to use"; $definition)
Führen Sie anschließend eine ORDA-Abfrage auf dem Vektorfeld durch. 4D vergleicht den Abfragevektor nativ mit denen Ihrer Entitäten, behält diejenigen bei, die den Ähnlichkeitsschwellenwert überschreiten, und sortiert sie vom ähnlichsten zum am wenigsten ähnlichen:
// Find the most similar students, best match first
var $students:=ds.Students.query("student_vector > :1 order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Wenn Sie ein „dirty field“ verwenden, fügen Sie einfach ein Kriterium hinzu, um Vektoren auszuschließen, die noch neu berechnet werden müssen:
var $students:=ds.Students.query("student_vector > :1 and student_vector_dirty = false order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Diese Suche kann einen Studenten finden, in dessen Biografie „intuitive Benutzeroberflächen“ und „Usability-Tests“ erwähnt werden, obwohl keines dieser Wörter in der Abfrage vorkommt.
Weitere Informationen zur Vektorsuche in 4D (Ähnlichkeitsmetriken, Schwellenwerte und die Kombination mit herkömmlichen Kriterien) finden Sie in unseren früheren Artikeln:
Da Sie nun alles haben, was Sie für den Einstieg benötigen, probieren Sie 4D Embedding Studio doch einfach in Ihrer eigenen Anwendung aus! Fügen Sie es zunächst Ihrem Projekt hinzu: Öffnen Sie „Design > Projektabhängigkeiten“, klicken Sie auf die Schaltfläche „+“ und wählen Sie die Registerkarte „GitHub“ aus. Wählen Sie „4D Embedding Studio“ aus der Liste der Standard-4D-Komponenten aus und fügen Sie es Ihrem Projekt hinzu.
Die Abhängigkeitsregel ist standardmäßig auf „4D-Version folgen“ eingestellt, sodass die Komponente stets mit Ihrer 4D-Version synchronisiert bleibt. Starten Sie Ihr Projekt neu, wenn Sie dazu aufgefordert werden, um die Komponente zu laden.
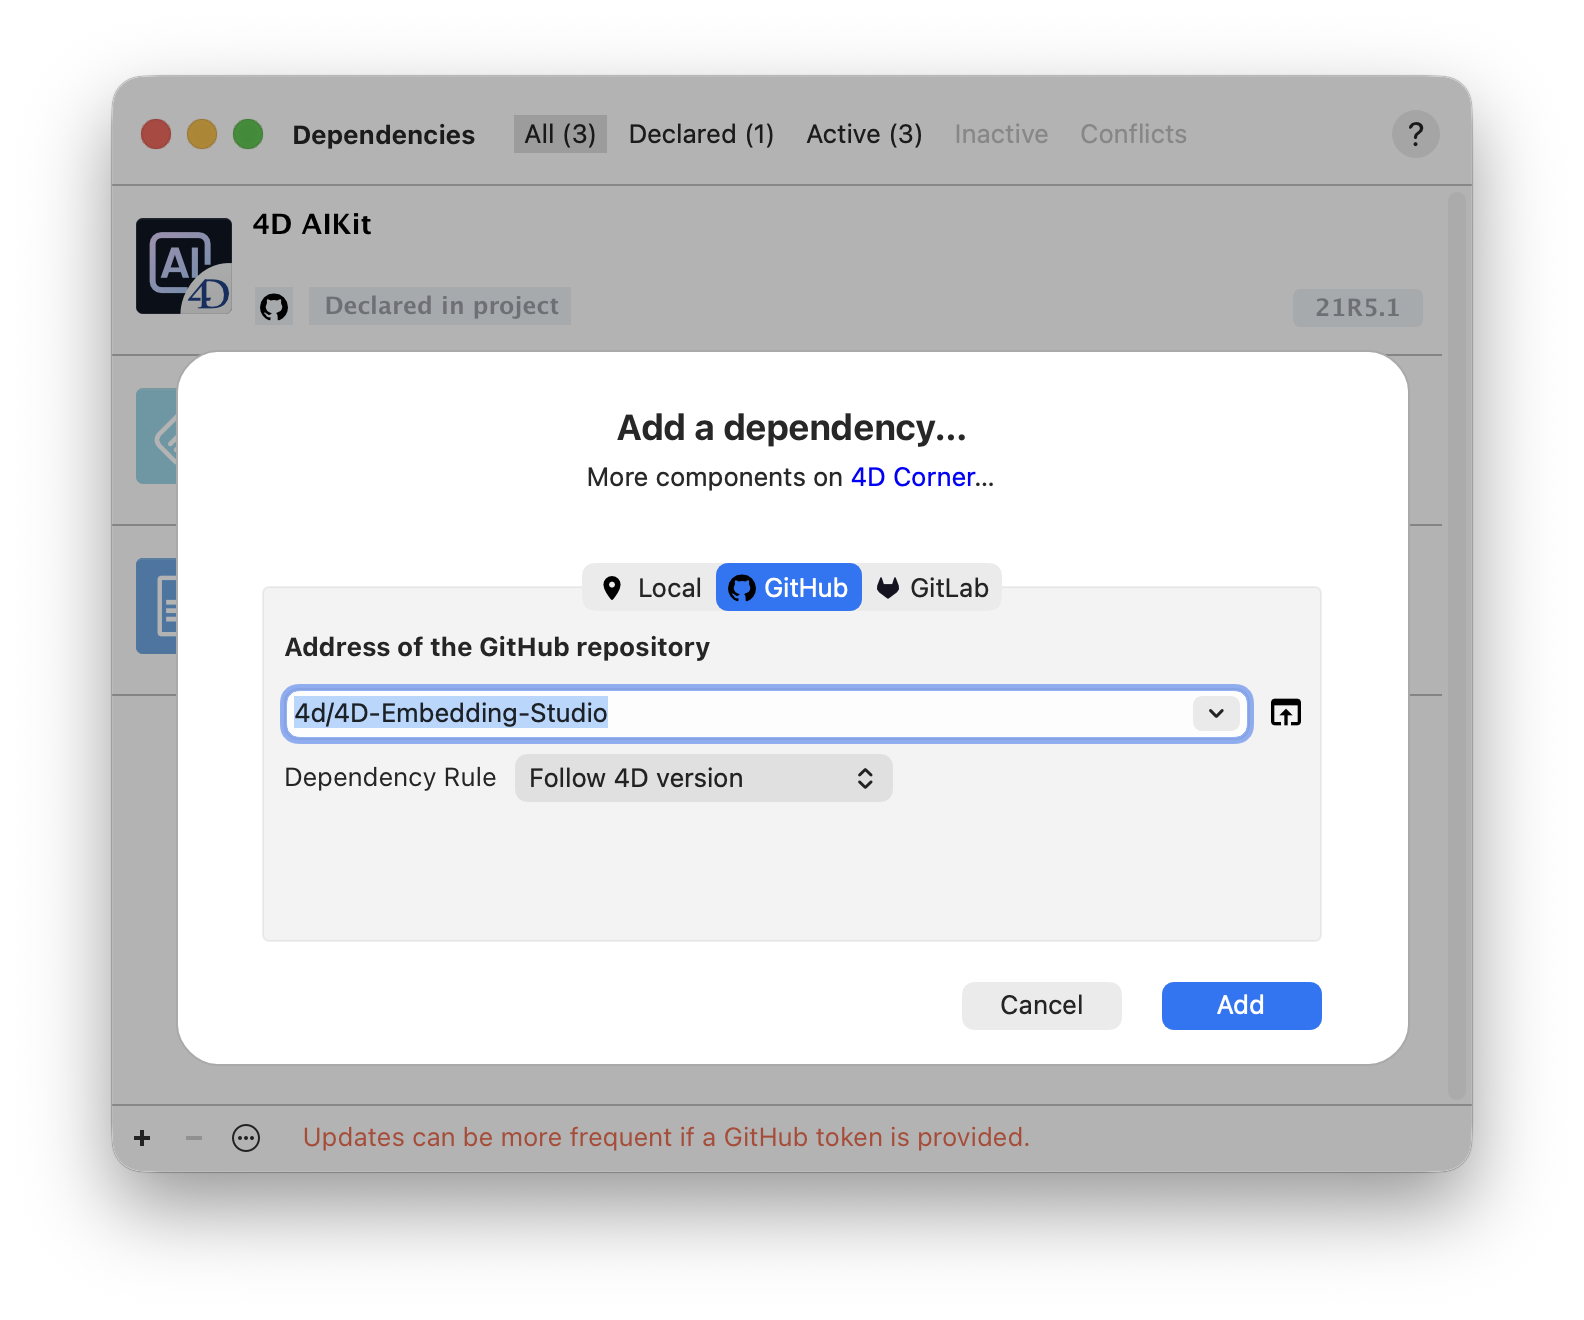
Weitere Informationen finden Sie unter „Projektabhängigkeiten verwalten “ und „Standard-4D-Komponenten verwalten“.
Mit 4D Embedding Studio übernimmt 4D alle für den Lebenszyklus Ihrer Einbettungen erforderlichen Abläufe:
Sie müssen diese Infrastruktur weder aufbauen noch warten: Ihr Code kann sich auf das konzentrieren, was Ihrer Anwendung einen Mehrwert bringt, wie beispielsweise die semantische Suche, Empfehlungen oder den Abgleich von Inhalten.
Lesen Sie die Dokumentation, um Ihr erstes Embedding zu konfigurieren und zu erfahren, wie Sie es in Ihre semantischen Suchen integrieren können.
Sie haben eine Frage, eine Anregung oder möchten einfach nur mit den 4D Bloggern in Kontakt treten? Schreiben Sie uns eine Nachricht!
* Ihre Privatsphäre ist uns sehr wichtig. Bitte klicken Sie hier, um unsere Politik
Für diesen Beitrag sind derzeit keine Kommentare verfügbar.