
Vectorisez vos données en toute simplicité avec 4D Embedding Studio
novembre 13, 2026
10 min de lecture
Les représentations vectorielles ouvrent la voie à de nombreux cas d’utilisation de l’IA dans vos applications 4D : recherche sémantique, recommandations, mise en correspondance de contenus et classification de documents.
Mais la création d’un embedding ne se résume pas à la génération d’un vecteur. À mesure que vos données évoluent, leurs représentations vectorielles doivent elles aussi être mises à jour. Vous devez détecter les changements, invalider les vecteurs concernés, les recalculer et gérer les erreurs potentielles ou les limites des services d’IA.
À partir de la version 4D 21 R5, l’ 4D Embedding Studio vous évite d’avoir à mettre en place toute cette infrastructure. Une interface vous permet de configurer vos embeddings, tandis que le planificateur gère leur cycle de vie, de l’invalidation au recalcul. Vous pouvez ainsi vous concentrer sur l’essentiel : utiliser les embeddings pour intégrer des fonctionnalités d’IA à vos applications.
Dans ce HDI, les recalculs sont déclenchés manuellement afin que vous puissiez observer chaque étape et obtenir des résultats immédiatement. Le planificateur, qui automatise ce processus en production, est présenté plus loin dans cet article.
Un embedding est une représentation vectorielle d’un contenu. Il transforme du texte ou d’autres informations en une séquence de nombres qu’un modèle d’IA peut comparer. Ainsi, des contenus ayant des significations similaires produisent des vecteurs similaires, même s’ils n’utilisent pas exactement les mêmes mots.
Avec 4D Embedding Studio, vous pouvez configurer la génération d’embeddings entièrement via l’interface :
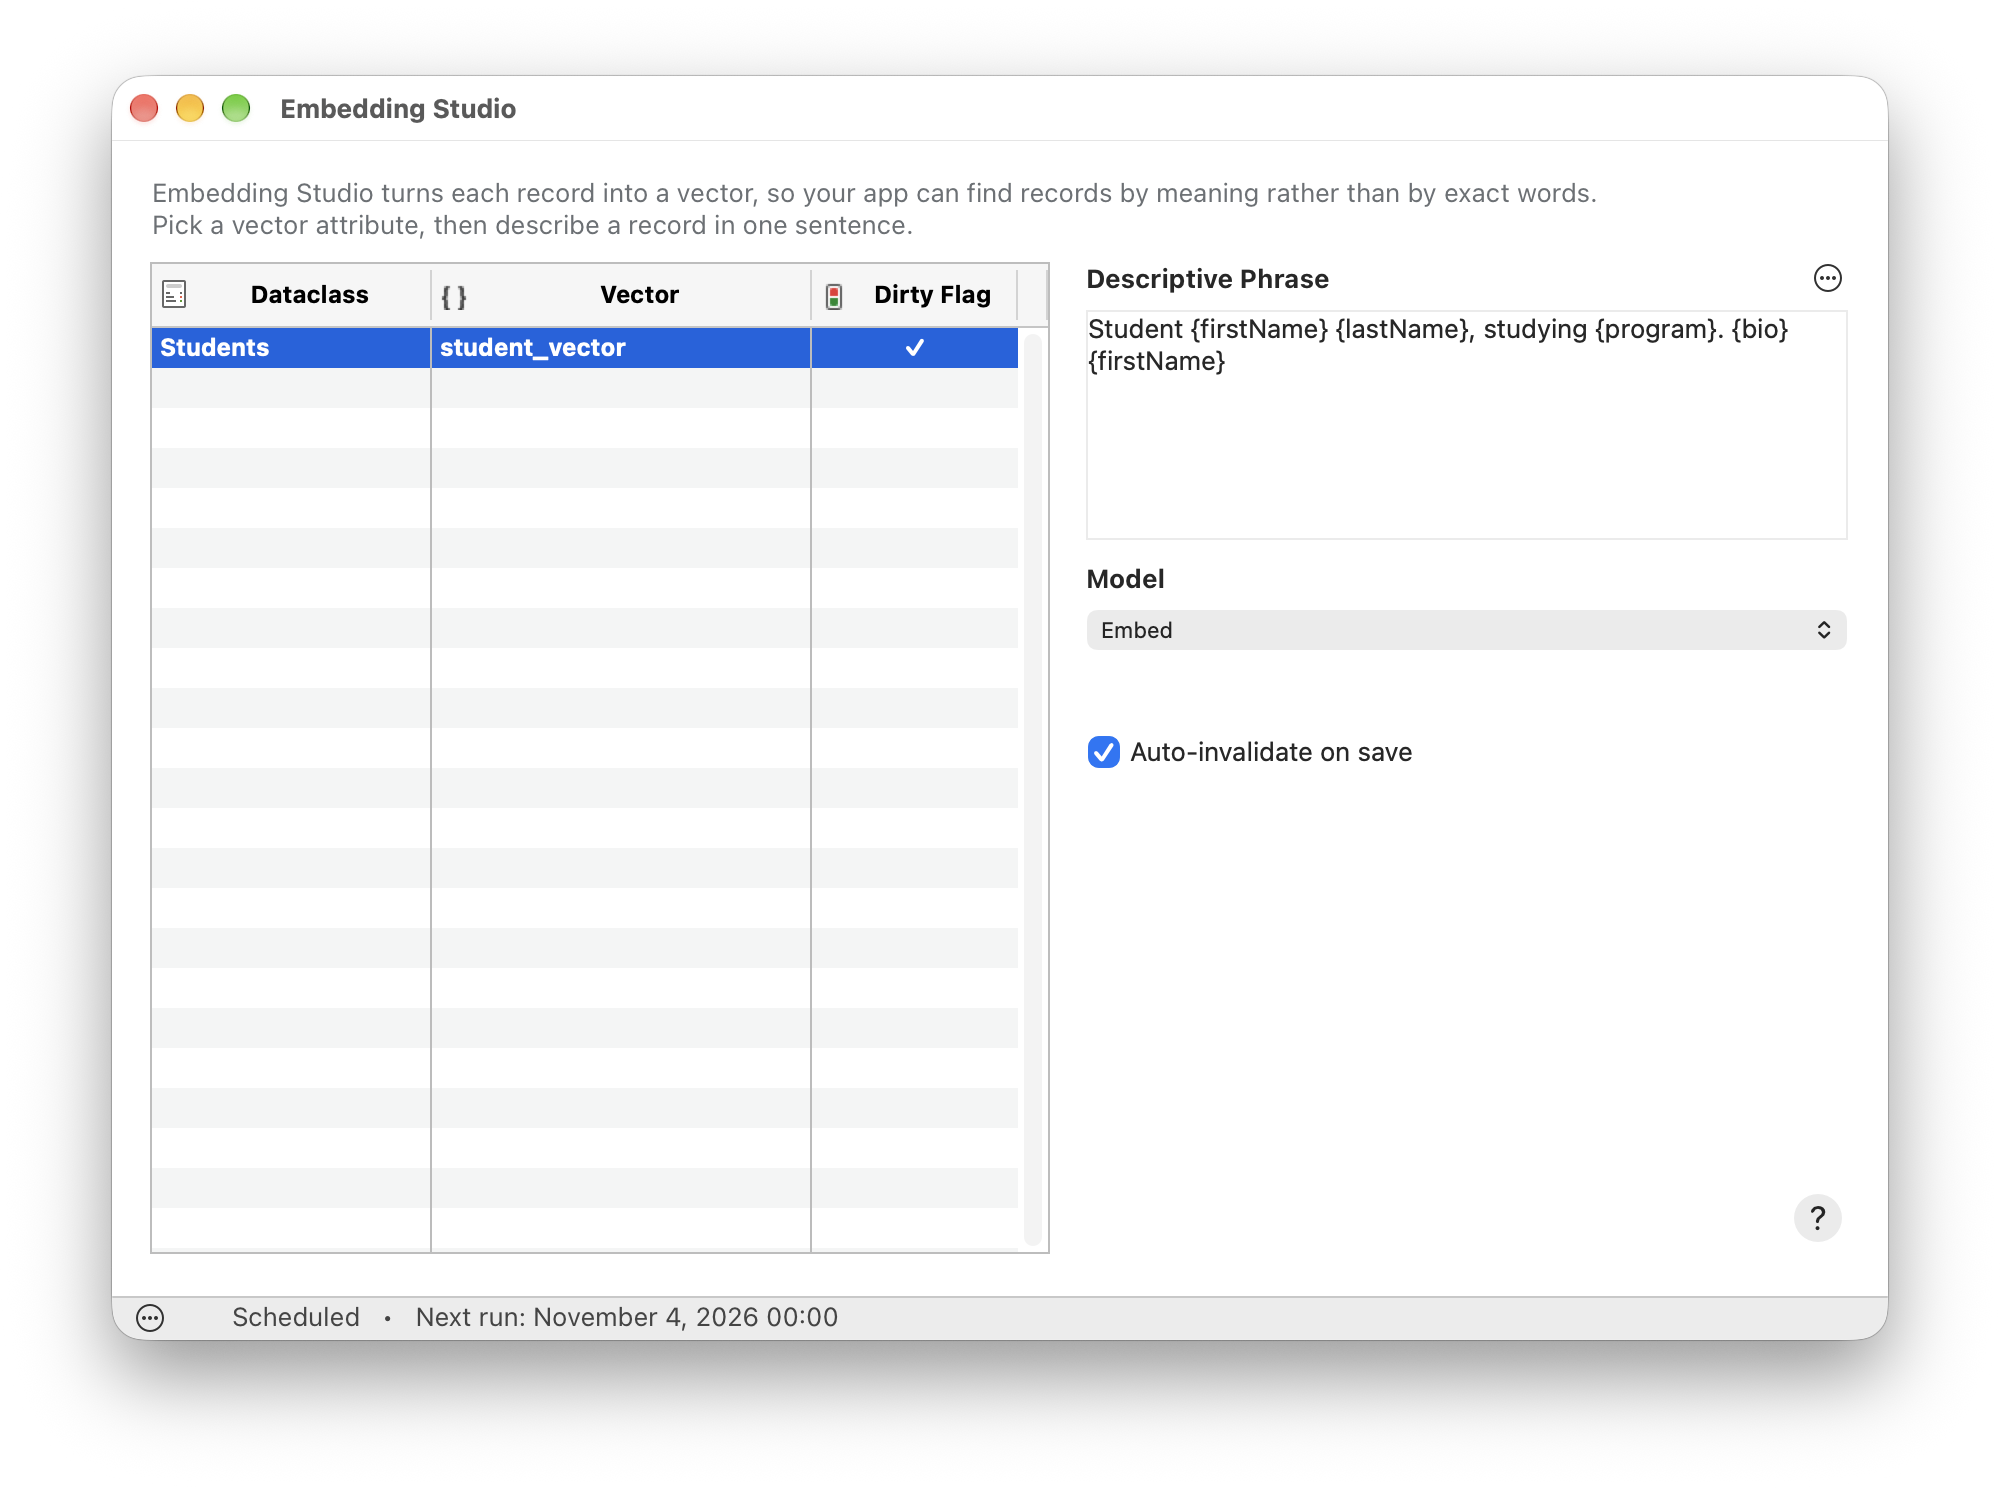
C’est tout. Vous n’avez pas besoin d’écrire la logique qui génère les vecteurs. 4D sait comment construire l’embedding à partir de votre configuration.
Vos vecteurs sont désormais prêts à être utilisés dans votre application, par exemple pour effectuer des recherches sémantiques.
Dans une application de production, les données ne sont jamais statiques. Si un encodage repose sur le titre et le contenu d’un document, toute modification apportée à l’un ou à l’autre doit être prise en compte.
En l’absence de mécanisme dédié, deux stratégies s’offrent à vous, mais aucune n’est idéale :
4D Embedding Studio adopte une approche plus ciblée. Lorsqu’une entité est modifiée, 4D détermine si le changement affecte la composition de son embedding. Seuls les vecteurs concernés sont invalidés et marqués pour être recalculés.
Vous n’avez pas besoin de développer ni de maintenir votre propre logique de détection des modifications.
Remarque : la détection s’applique aux champs de la table elle-même. Si le contenu de l’embedding utilise un attribut d’une table associée, un attribut calculé, un alias ou une propriété d’un objet, sa modification n’invalide pas automatiquement le vecteur. Dans ce cas, invalidez les vecteurs par programmation ou forcez leur recalcul.
Lorsqu’une modification nécessite la mise à jour d’une intégration, 4D Embedding Studio vous permet de choisir comment le vecteur doit être marqué comme obsolète.
Si aucun champ de suivi n’est défini, un vecteur invalidé est automatiquement remplacé par Null. Il n’est donc plus utilisé dans les recherches jusqu’à ce qu’il soit recalculé.
Cette option convient particulièrement aux applications qui privilégient une cohérence stricte : il vaut mieux ne renvoyer aucun résultat que de se fier à un embedding qui ne correspond plus aux données actuelles.
Vous pouvez également ajouter à la structure un champ booléen nommé « <vector_name>_dirty ». Lorsqu’une mise à jour est nécessaire, ce champ est défini sur « true » et le vecteur existant est conservé jusqu’à ce qu’il soit recalculé.
Votre application peut alors choisir de continuer à utiliser temporairement ce vecteur ou de l’exclure en filtrant sur «<vector_name>_dirty = false ».
Cette stratégie garantit la continuité du service tout en vous permettant d’identifier précisément les vecteurs en attente de recalcul.
La modification du modèle constitue un cas particulier : des modèles différents produisent des vecteurs qui ne peuvent pas être comparés entre eux. Après un changement de modèle, tous les vecteurs doivent donc être recalculés, et 4D Embedding Studio marque automatiquement tous les enregistrements concernés comme « sales ». Jusqu’à ce qu’ils soient recalculés, excluez-les de vos recherches à l’aide du filtre «<vector_name>_dirty = false ».
Si votre logique métier nécessite un contrôle total, vous pouvez également désactiver l’invalidation automatique et gérer vous-même ce cycle de vie.
Une fois les vecteurs marqués comme obsolètes, leur recalcul est géré par le planificateur de 4D Embedding Studio. Il vous suffit de choisir la fréquence d’exécution, puis de le lancer : soit en activant l’option « Exécuter la méthode ‘On Host Database Event’ des composants » dans les Paramètres de structure, sur la page Sécurité (désactivée par défaut), soit à l’aide d’une seule ligne de code :
cs.EmbeddingStudio.Scheduler.me.start()4D Embedding Studio orchestre alors le traitement pour vous.
Les recalculs s’exécutent de manière asynchrone sans bloquer les utilisateurs. Vous pouvez ajuster leur fréquence en fonction des besoins de votre application : les exécuter régulièrement, par lots, ou les déclencher à la demande, par exemple après un déploiement ou une modification majeure de vos données.
Une erreur n’interrompt pas le traitement : les vecteurs qui n’ont pas pu être calculés restent en attente et font l’objet d’une nouvelle tentative automatique lors de la prochaine exécution.
Cela vous permet de trouver le juste équilibre entre des résultats à jour, la charge de traitement et les coûts liés aux API d’IA, tandis que 4D se charge des mécanismes nécessaires au recalcul de vos embeddings.
Une fois vos vecteurs calculés, la recherche sémantique s’effectue en deux étapes.
Tout d’abord, calculez un embedding pour le texte saisi par l’utilisateur. Pour que les vecteurs soient comparables, celui-ci doit être calculé avec le même modèle que les vecteurs stockés. L’utilisation de la définition configurée dans 4D Embedding Studio garantit que vous utilisez le bon modèle.
// Retrieve the embedding definition configured in 4D Embedding Studio
var $settings:=cs.EmbeddingStudio.Settings.new()
var $definition:=$settings.find("Students"; "student_vector")

// Compute the vector of the user's query with the same model
var $result:=cs.EmbeddingStudio.Playground.new().embed("apps that are easy to use"; $definition)
Ensuite, lancez une requête ORDA sur le champ vectoriel. 4D compare nativement le vecteur de requête à ceux de vos entités, conserve ceux qui dépassent le seuil de similarité et les trie du plus proche au plus éloigné :
// Find the most similar students, best match first
var $students:=ds.Students.query("student_vector > :1 order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Si vous utilisez un champ « sale », il suffit d’ajouter un critère pour exclure les vecteurs en attente de recalcul :
var $students:=ds.Students.query("student_vector > :1 and student_vector_dirty = false order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Cette recherche permet de trouver un étudiant dont la biographie mentionne les termes « interfaces intuitives » et « tests d’ergonomie », même si aucun de ces mots n’apparaît dans la requête.
Pour en savoir plus sur la recherche vectorielle dans 4D (mesures de similarité, seuils et combinaison avec des critères traditionnels), consultez nos articles précédents :
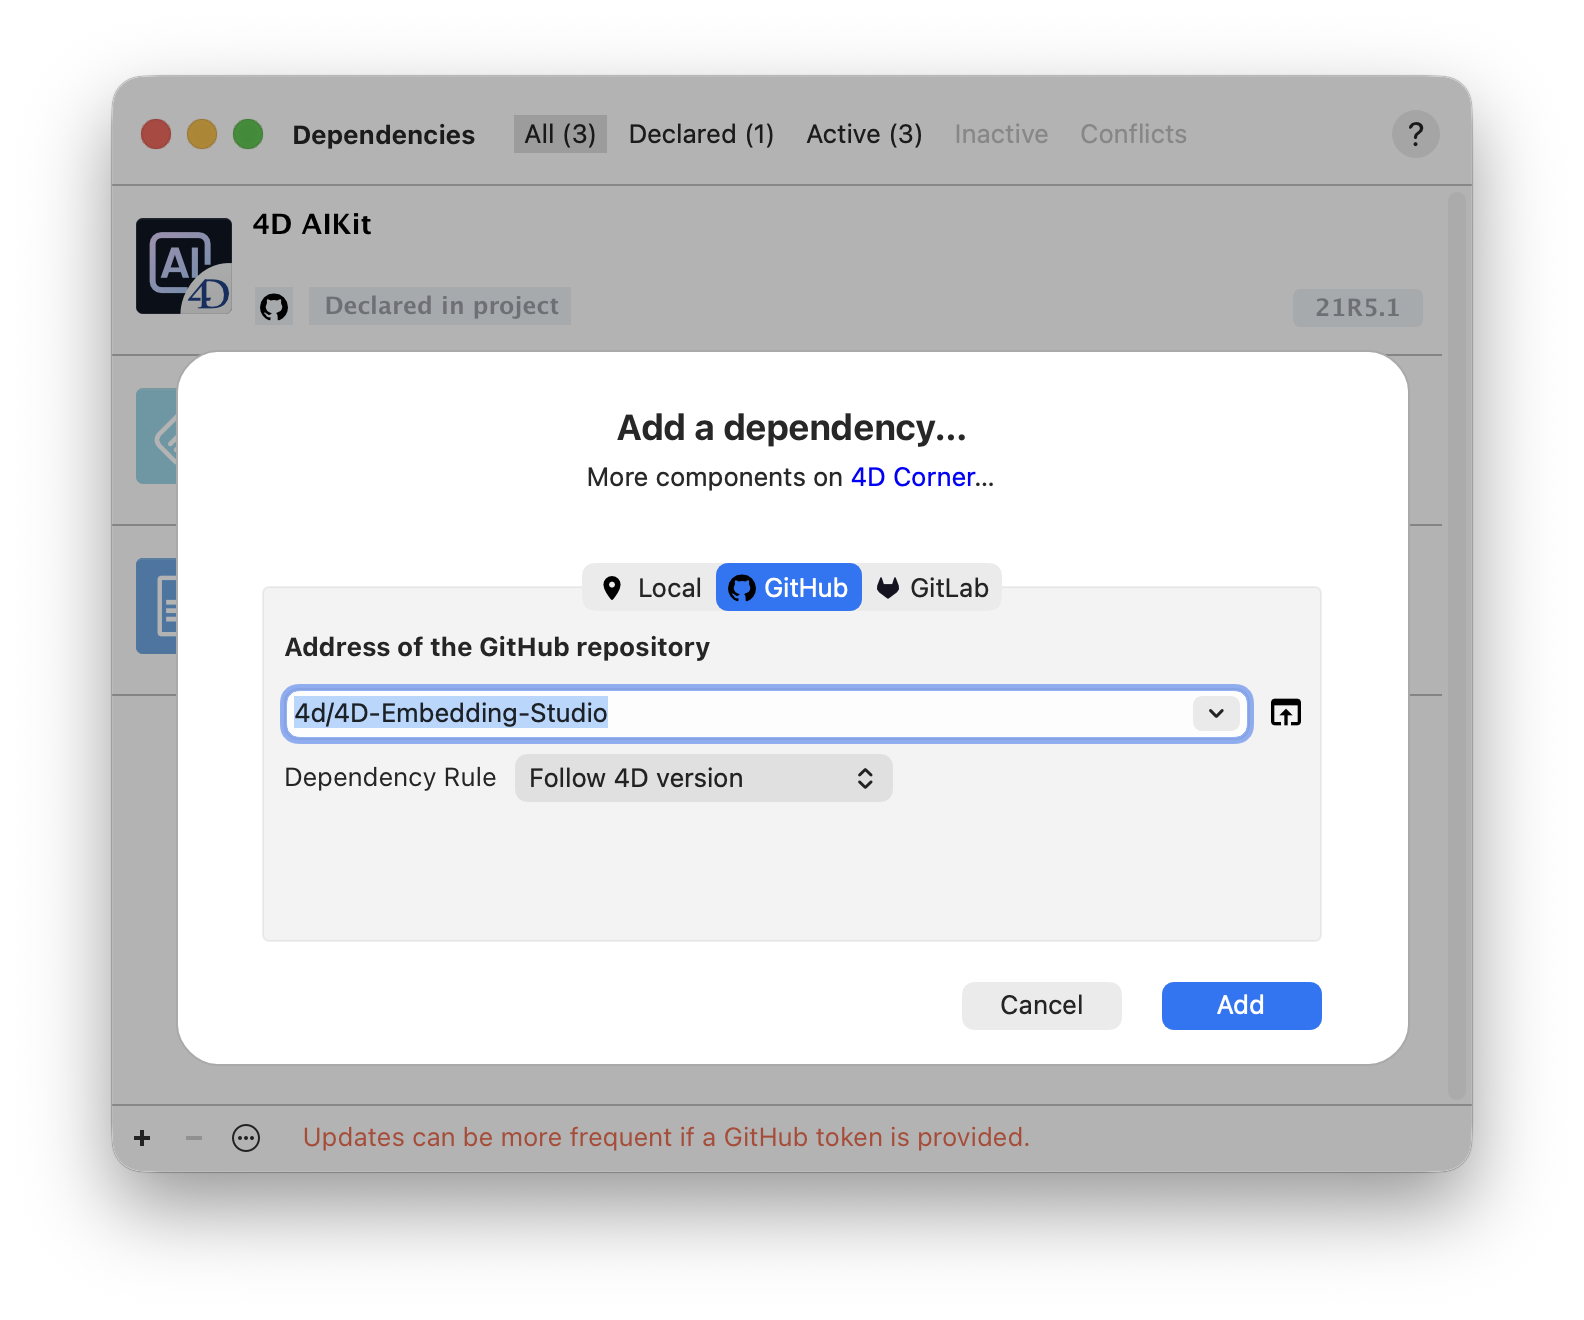
Maintenant que vous disposez de tout ce dont vous avez besoin pour vous lancer, pourquoi ne pas essayer 4D Embedding Studio dans votre propre application ? Commencez par l’ajouter à votre projet : ouvrez « Conception > Dépendances du projet », cliquez sur le bouton « + », puis sélectionnez l’onglet « GitHub ». Choisissez « 4D Embedding Studio » dans la liste des composants 4D standard, puis ajoutez-le à votre projet.
La règle de dépendance est définie par défaut sur « Suivre la version 4D », ce qui garantit la compatibilité du composant avec votre version de 4D. Redémarrez votre projet lorsque vous y êtes invité pour charger le composant.
Pour plus d’informations, consultez les sections Gestion des dépendances de projet et Maîtriser les composants 4D standard.
Avec 4D Embedding Studio, 4D gère tous les aspects techniques liés au cycle de vie de vos intégrations :
Vous n’avez pas besoin de mettre en place ni de maintenir cette infrastructure : votre code peut se concentrer sur ce qui apporte de la valeur à votre application, comme la recherche sémantique, les recommandations ou la mise en correspondance de contenus.
Consultez la documentation pour configurer votre premier embedding et découvrir comment l’intégrer à vos recherches sémantiques.
Vous avez une question, une suggestion ou vous voulez simplement entrer en contact avec les blogueurs 4D ? Envoyez-nous un message !
* Votre vie privée est très importante pour nous. Veuillez cliquer ici pour consulter notre Politique
Les commentaires ne sont pas disponibles pour cet article pour le moment.