
4D Embedding Studio を使えば、データを簡単にベクトル化できます
11月 13, 2026
2 読了時間
エンベディングは、4Dアプリケーションにおける多くのAI活用事例――セマンティック検索、レコメンデーション、コンテンツマッチング、文書分類――への道を開きます。
しかし、エンベディングの作成には、単にベクトルを生成する以上の作業が伴います。データが変化するにつれて、そのベクトル表現も更新する必要があります。変化を検出し、影響を受けたベクトルを無効化し、再計算を行い、AIサービスの潜在的なエラーや制限に対処する必要があります。
4D 21 R5以降、4D Embedding Studio を利用することで、こうしたインフラをすべて構築する手間が省けます。インターフェースを使用してエンベディングを設定すれば、スケジューラが無効化から再計算に至るまでのライフサイクルを管理します。これにより、エンベディングを活用してアプリケーションにAI機能を導入するという、本質的な業務に集中できるようになります。
このHDIでは、再計算を手動でトリガーするため、各ステップを確認し、即座に結果を得ることができます。本番環境でこのプロセスを自動化するスケジューラーについては、この記事の後半で説明します。
エンベディングとは、コンテンツをベクトルで表現したものです。テキストやその他の情報を、AIモデルが比較可能な数値のシーケンスに変換します。その結果、たとえまったく同じ単語が使われていなくても、意味が類似したコンテンツは類似したベクトルを生成します。
4D Embedding Studio を使用すると、インターフェースだけで埋め込みの生成を完全に設定できます:
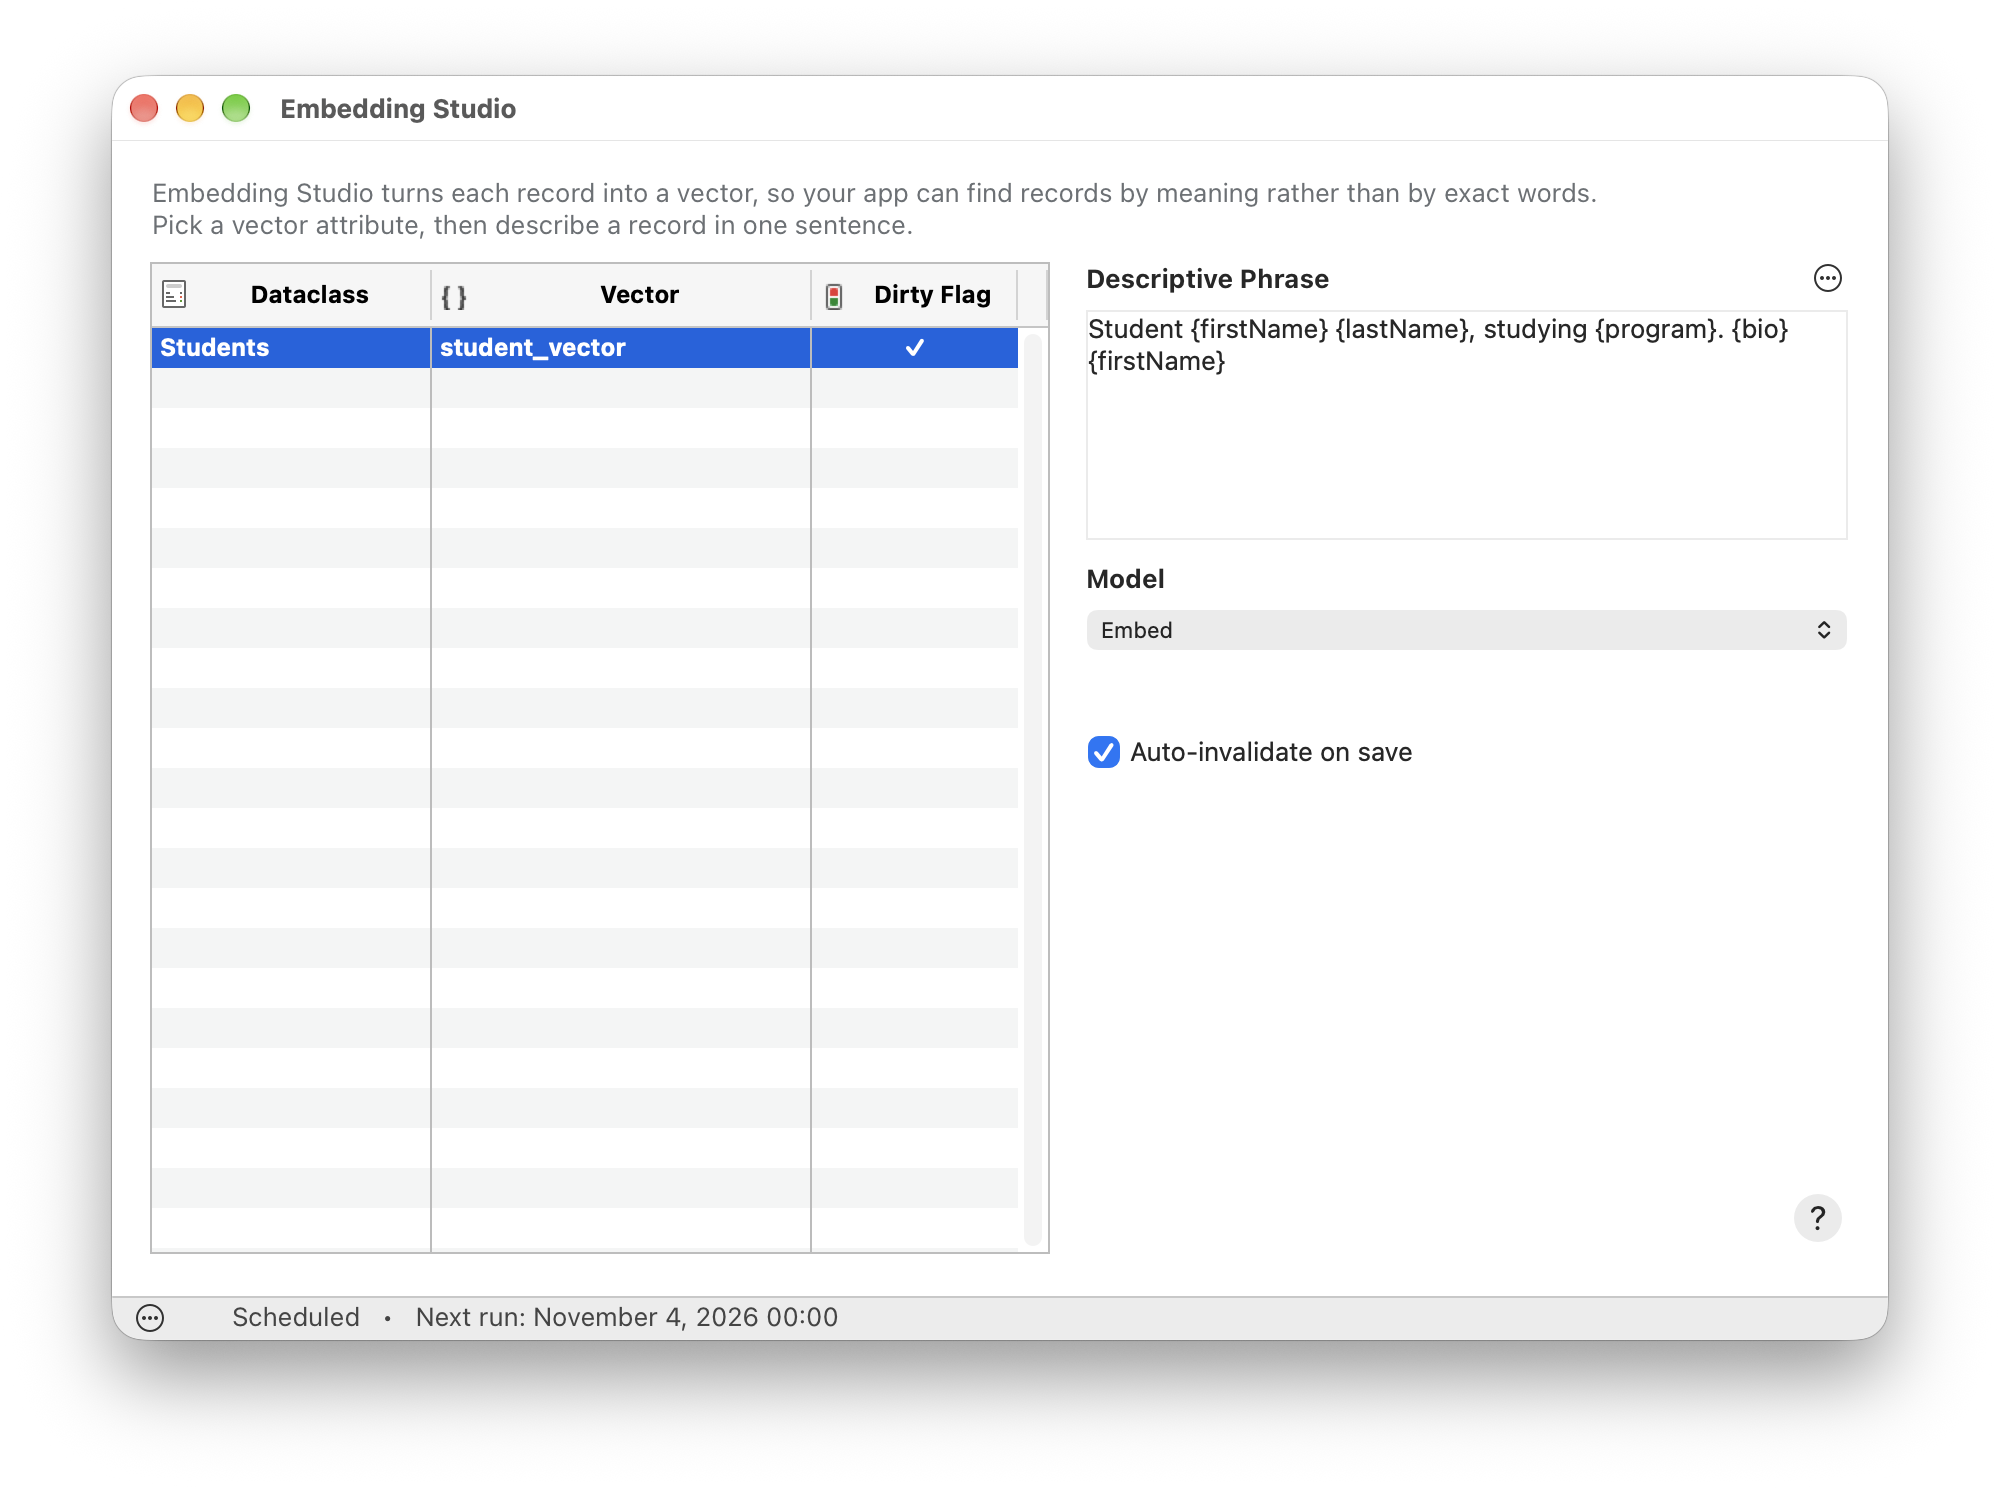
これで完了です。ベクトルを生成するロジックを記述する必要はありません。4D は、設定に基づいて埋め込みを構築する方法を認識しています。
これで、アプリケーションでベクトルを使用できるようになりました。たとえば、セマンティック検索を実行することができます。
本番環境のアプリケーションでは、データは決して静的なものではありません。埋め込みがドキュメントのタイトルやコンテンツに基づいている場合、いずれかに変更があった場合は、その変更を反映させる必要があります。
専用のメカニズムがない場合、2つの戦略が考えられますが、いずれも理想的とは言えません:
4D Embedding Studioは、より的を絞ったアプローチを採用しています。エンティティが変更された際、4Dはその変更がエンベディングの構成に影響するかどうかを判断します。影響を受けたベクトルのみが無効化され、再計算の対象としてマークされます。
独自の変更検出ロジックを開発・維持する必要はありません。
注:検出はテーブル自体のフィールドに適用されます。エンベディングの内容が、関連テーブルの属性、計算属性、エイリアス、またはオブジェクトのプロパティを使用している場合、それらを変更してもベクトルは自動的に無効化されません。その場合は、プログラムでベクトルを無効化するか、再計算を強制してください。
変更によって埋め込みの更新が必要になった場合、4D Embedding Studio では、ベクトルをどのように「古くなった」ものとしてマークするかを選択できます。
追跡フィールドが定義されていない場合、無効化されたベクトルは自動的にNullに置き換えられます。そのため、再計算されるまでは検索に使用されなくなります。
このオプションは、厳密な一貫性を優先するアプリケーションに適しています。現在のデータと一致しなくなった埋め込みに依存するよりも、結果を返さない方が望ましいからです。
また、構造体に「<vector_name>_dirty 」という名前のブール型フィールドを追加することもできます。更新が必要な場合、このフィールドは true に設定され、再計算されるまで既存のベクトルが保持されます。
その後、アプリケーションでは、このベクトルを一時的に使い続けるか、「<vector_name>_dirty = false」でフィルタリングして除外するかを選択できます。
この戦略により、サービスの継続性が確保されると同時に、再計算待ちのベクトルを正確に特定することができます。
モデルの変更は特別なケースです。モデルが異なると、互いに比較できないベクトルが生成されます。そのため、モデル変更後はすべてのベクトルを再計算する必要があり、4D Embedding Studio は影響を受けるすべてのレコードを自動的に「ダーティ」としてマークします。再計算されるまでは、「<vector_name>_dirty =false」フィルターを使用して、検索対象から除外してください。
ビジネスロジック上、完全な制御が必要な場合は、自動無効化を無効にして、このライフサイクルを自身で管理することも可能です。
ベクトルが古くなったとマークされると、その再計算は 4D Embedding Studio のスケジューラによって処理されます。 実行頻度を選択し、以下のいずれかの方法で開始するだけです。構造設定の「セキュリティ」ページで「コンポーネントの『On Host Database Event』メソッドを実行する」オプションを有効にする(デフォルトでは無効)、または1行のコードで実行します:
cs.EmbeddingStudio.Scheduler.me.start()4D Embedding Studioが処理を自動的に調整します。
再計算は非同期で実行されるため、ユーザーの操作を妨げることはありません。アプリケーションのニーズに合わせて実行頻度を調整できます。例えば、定期的な実行、バッチ更新、あるいはデプロイ後やデータへの大幅な変更後など、必要に応じてトリガーすることも可能です。
エラーが発生しても処理は中断されません。計算できなかったベクトルは保留状態となり、次回の実行時に自動的に再試行されます。
これにより、最新の結果、処理負荷、AI API コストの適切なバランスを見極めることができ、4D がエンベディングの再計算に必要な処理を自動的に行います。
ベクトルの計算が完了すると、セマンティック検索は2つのステップで行われます。
まず、ユーザーが入力したテキストの埋め込みを計算します。ベクトルを比較可能にするためには、保存されているベクトルと同じモデルを使用して計算する必要があります。4D Embedding Studio で設定された定義を使用することで、正しいモデルが確実に使用されます。
// Retrieve the embedding definition configured in 4D Embedding Studio
var $settings:=cs.EmbeddingStudio.Settings.new()
var $definition:=$settings.find("Students"; "student_vector")

// Compute the vector of the user's query with the same model
var $result:=cs.EmbeddingStudio.Playground.new().embed("apps that are easy to use"; $definition)
次に、ベクトルフィールドに対してORDAクエリを実行します。4Dは、クエリベクトルとエンティティのベクトルをネイティブに比較し、類似性閾値を超えるものを保持して、最も近いものから遠いものの順に並べ替えます:
// Find the most similar students, best match first
var $students:=ds.Students.query("student_vector > :1 order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
ダーティフィールドを使用する場合は、再計算待ちのベクトルを除外する条件を追加するだけで済みます:
var $students:=ds.Students.query("student_vector > :1 and student_vector_dirty = false order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
この検索では、クエリにそれらの単語が一切含まれていなくても、経歴に「直感的なインターフェース」や「ユーザビリティテスト」という記述がある学生を見つけることができます。
4Dにおけるベクトル検索(類似度メトリクス、閾値、および従来の条件との組み合わせ)の詳細については、以下の過去の記事をご覧ください:
開始するために必要なものはすべて揃いましたので、ご自身のアプリケーションで4D Embedding Studioを試してみてはいかがでしょうか?まず、プロジェクトに追加します。「Design > Project Dependencies」を開き、「+」ボタンをクリックして、「GitHub」タブを選択してください。 標準の4Dコンポーネントのリストから「4D Embedding Studio」を選択し、プロジェクトに追加します。
依存関係ルールはデフォルトで「4Dバージョンに準拠」に設定されており、コンポーネントが使用中の4Dバージョンと常に同期されます。コンポーネントを読み込むよう促されたら、プロジェクトを再起動してください。
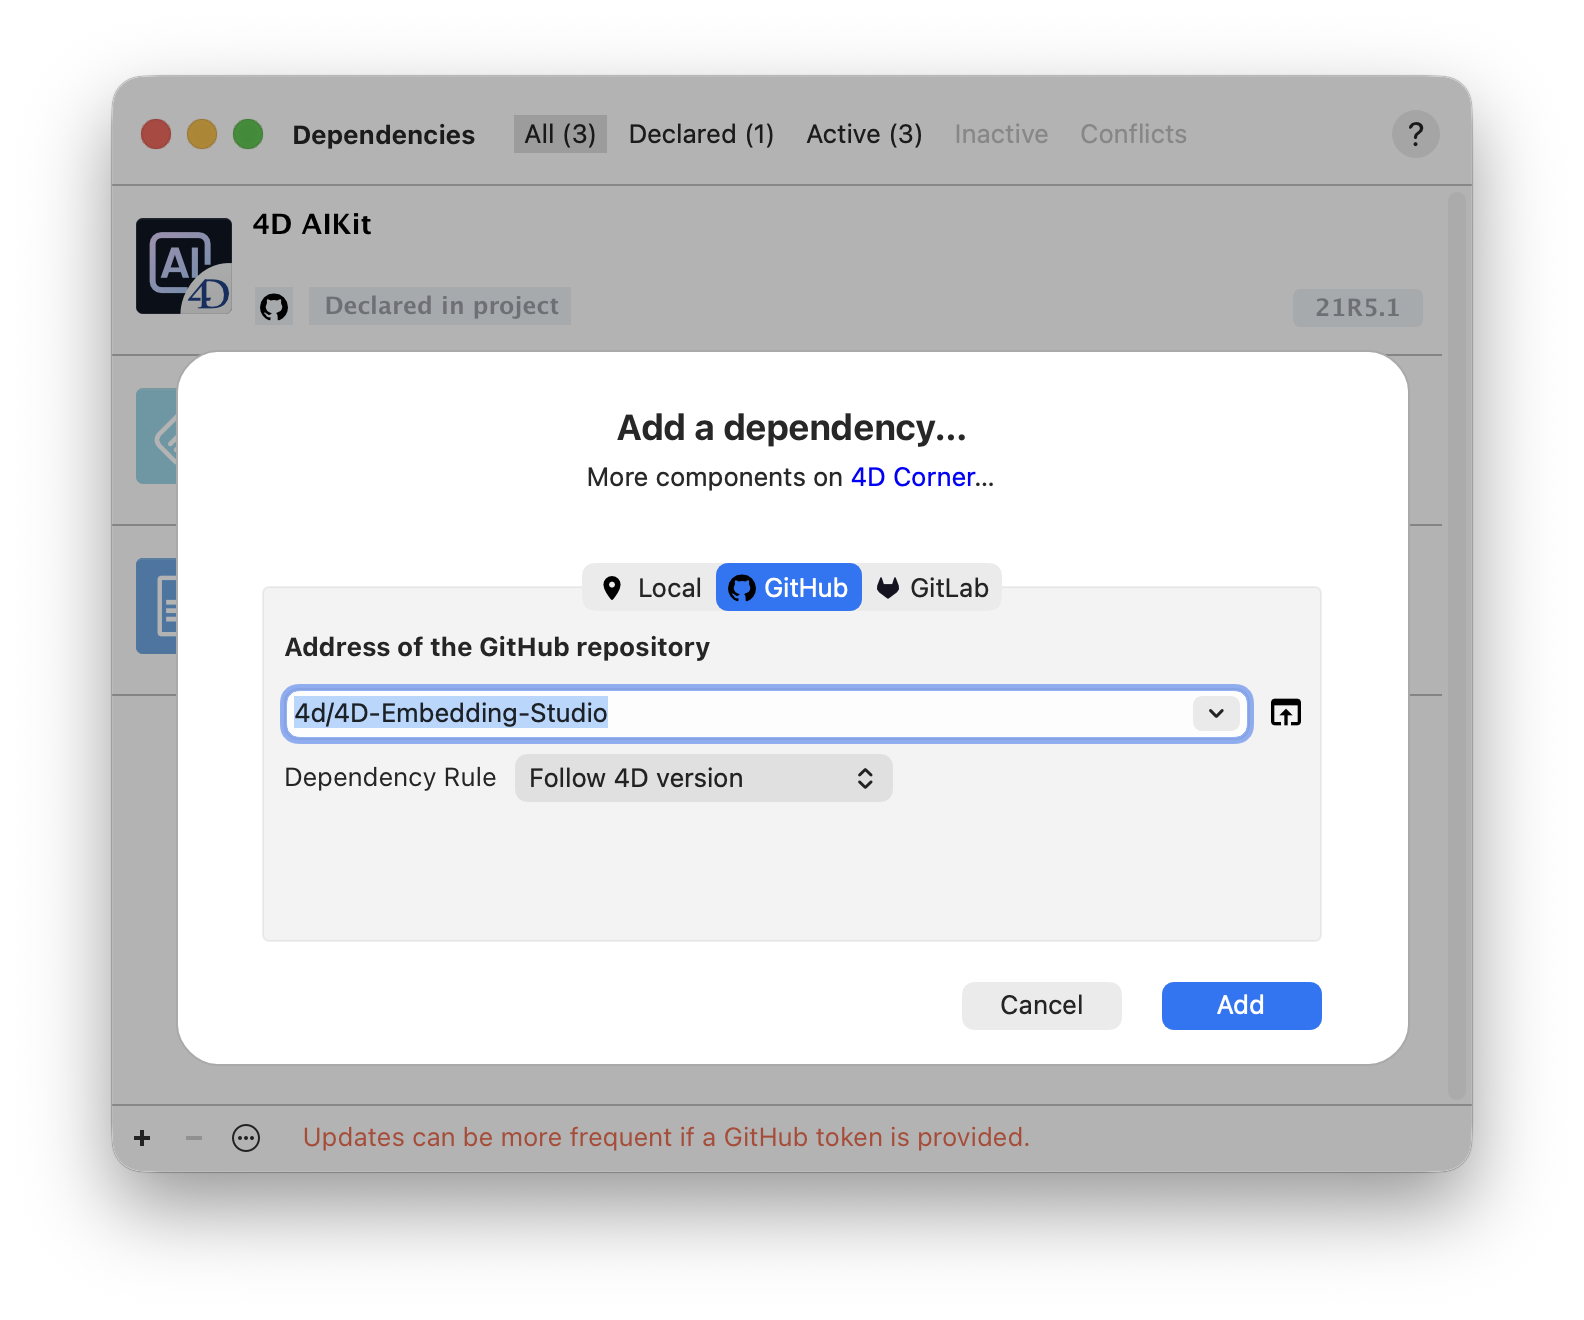
詳細については、「プロジェクトの依存関係の管理」および「標準 4D コンポーネントの制御」を参照してください。
4D Embedding Studio を使用すると、4D が埋め込みコンポーネントのライフサイクルに必要なすべての処理を処理します。
このインフラストラクチャを構築・維持する必要はありません。コードでは、セマンティック検索、レコメンデーション、コンテンツマッチングなど、アプリケーションに価値をもたらす機能に集中できます。
ドキュメントを参照して、最初のエンベディングを設定し、それをセマンティック検索に統合する方法を学んでください。
現在、この投稿へのコメント機能は利用できません。