
4次元におけるベクトルインデックス:4次元ベクトル場の類似性検索を高速化
10月 20, 2026
1 読了時間
ベクトルデータは、セマンティック検索、レコメンデーションエンジン、RAG(Retrieval-Augmented Generation)パイプラインなど、現代のAIを活用した機能の中核をなしています。4D やVector といったフィールドが4Dデータベースにおいて重要な位置を占めるようになるにつれ、データセットの規模が拡大してもクエリの高速性を維持するためには、これらを効率的にインデックス化できることが不可欠です。本記事では、4Dにおけるベクトルインデックスの仕組み、サポートされているアルゴリズム、およびプログラムによるベクトルインデックスの管理方法について解説します。
ベクトルフィールドに対するクエリとは、通常、類似度メトリックを用いて、参照ベクトルに「最も近い」ベクトルを持つレコードを検索することを意味します。インデックスがない場合、4Dはテーブル内のすべてのベクトルをスキャンし、1つずつ距離を計算する必要があります。これは正しい処理ですが、テーブルが大きくなるにつれて処理速度が低下します。
ベクトルインデックスを使用すると、4Dはベクトル類似性検索用に特別に設計されたアルゴリズムを使用し、インデックスのないクエリと同じ結果を返す一方で、クエリ時間を劇的に短縮します。つまり:
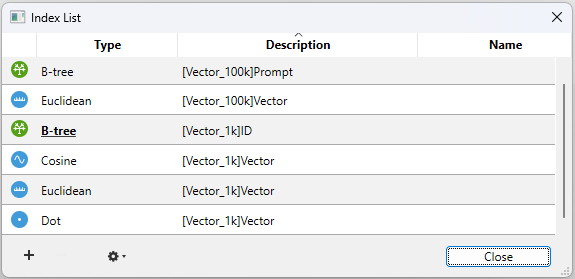
4Dでは、既存の「標準」インデックスに加え、4D.Vectorフィールド専用の3つのインデックスタイプが導入されています:
| 定数 | ユースケース |
|---|---|
ベクトルコサインインデックス |
ベクトル間の角度に基づく類似度 |
ベクトル内積インデックス |
内積に基づく類似度 |
ベクトルのユークリッド距離指標 |
直線距離に基づく類似度 |
これらは以下を通じて利用可能です CREATE INDEX および SET INDEXを通じて利用可能であり、各指標タイプは個別に選択できるため、1つのベクトルフィールドに複数の指標を同時に設定することが可能です(例:コサインとユークリッドの両方)。
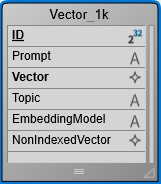
ベクトルフィールドとそのインデックスは、構造エディタおよび関連するダイアログに完全に統合されています。
 が表示されます。
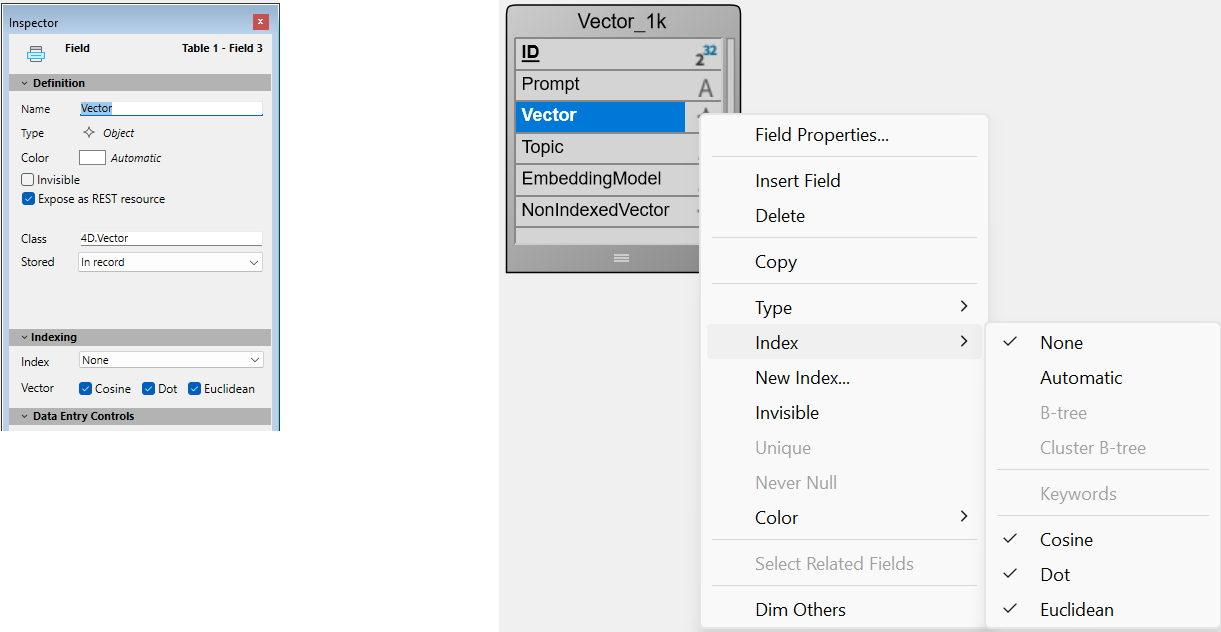
4D は、ベクトルインデックスとデータの一貫性を自動的に維持します:
以下の点に注意してください:
ベクトルインデックスは、4Dのメンテナンスおよび管理ツール全体において、第一級の要素として扱われます:
4D。Vector 。new() は、32 ビットまたは 64 ビット(定数mk single precision およびmk double precision )の精度パラメータを受け入れるようになりました。デフォルトでは、新しいベクトルは32 ビット精度(コンポーネントあたり 4 バイト)で作成されます。 これにより、64ビットベクトルと比較してメモリ使用量が半分に削減される一方で、類似度や距離の計算に十分な精度が維持されるため、ほとんどのユースケースにおいて推奨されるデフォルト設定となっています。
$vector32:=4D.Vector.new([1; 2; 3])
// $vector32.precision=32

$vector64:=4D.Vector.new([1; 2; 3]; mk double precision)
// $vector64.precision=64
互換性に関する注意:この変更により、以前の 64 ビットのデフォルト設定に依存していた既存のコードとの互換性が失われます。64 ビットの精度を維持するには、mk double precision を明示的に渡してください。
4Dのベクトルインデックス機能により、一貫性や使いやすさを損なうことなく、データベースエンジン内で直接、実運用レベルのパフォーマンスを持つ類似度検索が可能になります。レコメンデーションシステム、セマンティック検索機能、RAGパイプラインのいずれを構築する場合でも、以下のことが可能になります:
従来通り、インデックス化されたクエリとインデックス化されていないクエリは同一の結果を返します。インデックスはあくまでパフォーマンスの最適化を目的としたものであり、動作の変更をもたらすことはありません。
現在、この投稿へのコメント機能は利用できません。