
Vettorializza i tuoi dati in tutta semplicità con 4D Embedding Studio
Novembre 13, 2026
8 Tempo di lettura
Gli embedding aprono la strada a numerosi casi d’uso dell’IA nelle vostre applicazioni 4D: ricerca semantica, consigli, abbinamento dei contenuti e classificazione dei documenti.
Ma la creazione di un embedding non si limita alla generazione di un vettore. Man mano che i dati cambiano, anche le loro rappresentazioni vettoriali devono essere aggiornate. È necessario rilevare le modifiche, invalidare i vettori interessati, ricalcolarli e gestire potenziali errori o limitazioni dei servizi di IA.
A partire da 4D 21 R5, l’ 4D Embedding Studio a vi evita di dover costruire tutta questa infrastruttura. Un’interfaccia vi permette di configurare i vostri embedding, mentre lo scheduler ne gestisce il ciclo di vita, dall’invalidazione al ricalcolo. Questo vi permette di concentrarvi su ciò che conta: utilizzare gli embedding per integrare funzionalità di IA nelle vostre applicazioni.
In questo HDI, i ricalcoli vengono attivati manualmente in modo da poter osservare ogni fase e ottenere risultati immediatamente. Lo scheduler, che automatizza questo processo in produzione, viene spiegato più avanti in questo articolo.
Un embedding è una rappresentazione vettoriale di un contenuto. Trasforma il testo o altre informazioni in una sequenza di numeri che un modello di IA può confrontare. Di conseguenza, contenuti con significati simili producono vettori simili, anche quando non utilizzano esattamente le stesse parole.
Con 4D Embedding Studio, è possibile configurare la generazione degli embedding interamente tramite l’interfaccia:
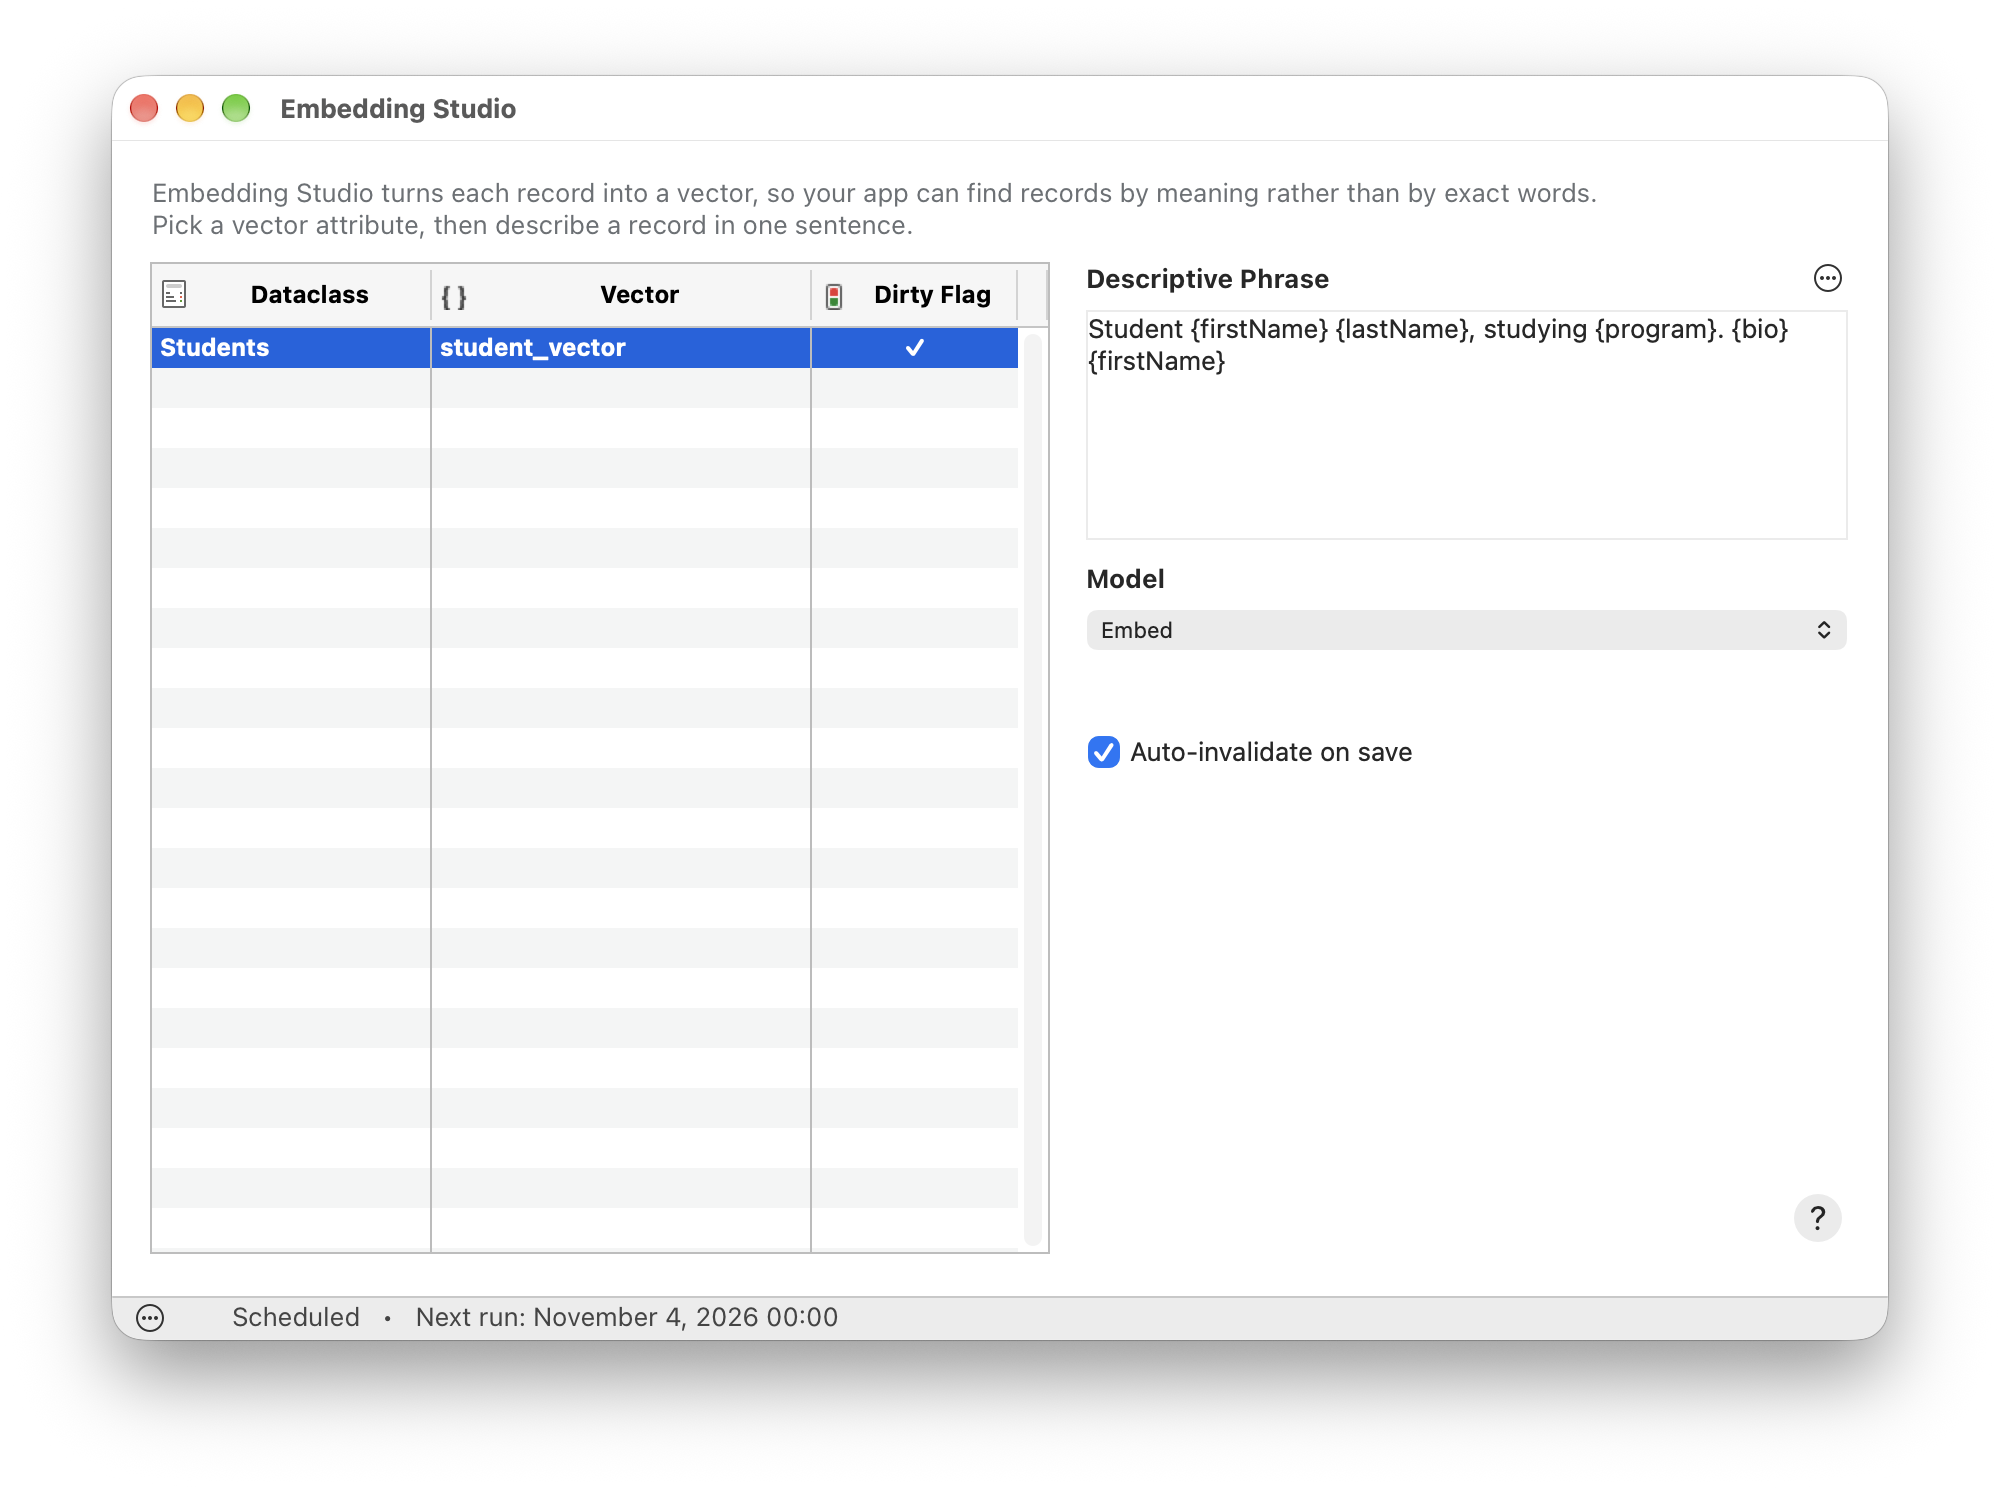
Questo è tutto. Non è necessario scrivere la logica che genera i vettori. 4D sa come costruire l’embedding a partire dalla configurazione fornita.
I tuoi vettori sono ora pronti per essere utilizzati nella tua applicazione, ad esempio per eseguire ricerche semantiche.
In un’applicazione di produzione, i dati non sono mai statici. Se un embedding si basa sul titolo e sul contenuto di un documento, è necessario tenere conto di qualsiasi modifica apportata a entrambi.
Senza un meccanismo dedicato, hai due possibili strategie, nessuna delle quali è ideale:
4D Embedding Studio adotta un approccio più mirato. Quando un’entità viene modificata, 4D determina se la modifica influisce sulla composizione del relativo embedding. Solo i vettori interessati vengono invalidati e contrassegnati per il ricalcolo.
Non è necessario sviluppare o mantenere una propria logica di rilevamento delle modifiche.
Nota: il rilevamento si applica ai campi presenti nella tabella stessa. Se il contenuto dell’embedding utilizza un attributo proveniente da una tabella correlata, un attributo calcolato, un alias o una proprietà di un oggetto, la sua modifica non invalida automaticamente il vettore. In tal caso, è necessario invalidare i vettori a livello di programmazione o forzare il loro ricalcolo.
Quando una modifica richiede l’aggiornamento di un’incorporazione, 4D Embedding Studio consente di scegliere come contrassegnare il vettore come obsoleto.
Se non è definito alcun campo di tracciamento, un vettore invalidato viene automaticamente sostituito con Null. Non viene quindi più utilizzato nelle ricerche finché non viene ricalcolato.
Questa opzione funziona bene per le applicazioni che danno priorità a una coerenza rigorosa: è meglio non restituire alcun risultato piuttosto che fare affidamento su un embedding che non corrisponde più ai dati attuali.
È inoltre possibile aggiungere alla struttura un campo booleano denominato ` <vector_name>_dirty `. Quando è necessario un aggiornamento, questo campo viene impostato su `true` e il vettore esistente viene mantenuto fino a quando non viene ricalcolato.
L’applicazione può quindi scegliere di continuare a utilizzare temporaneamente questo vettore oppure di escluderlo filtrando su “<vector_name>_dirty = false”.
Questa strategia garantisce la continuità del servizio, consentendo al contempo di identificare esattamente quali vettori sono in attesa di essere ricalcolati.
La modifica del modello rappresenta un caso particolare: modelli diversi producono vettori che non possono essere confrontati tra loro. Dopo una modifica del modello, tutti i vettori devono quindi essere ricalcolati e 4D Embedding Studio contrassegna automaticamente tutti i record interessati come “dirty”. Finché non vengono ricalcolati, escludeteli dalle vostre ricerche con il filtro “<vector_name>_dirty =false”.
Se la vostra logica di business richiede un controllo completo, potete anche disabilitare l’invalidazione automatica e gestire autonomamente questo ciclo di vita.
Una volta che i vettori sono contrassegnati come obsoleti, il loro ricalcolo viene gestito dallo scheduler di 4D Embedding Studio. Basta scegliere la frequenza di esecuzione, quindi avviarlo: abilitando l’opzione “Esegui il metodo ‘On Host Database Event’ dei componenti” nelle Impostazioni della struttura, nella pagina Sicurezza (disabilitata per impostazione predefinita), oppure con una singola riga di codice:
cs.EmbeddingStudio.Scheduler.me.start()4D Embedding Studio coordina quindi l’elaborazione per conto dell’utente.
I ricalcoli vengono eseguiti in modo asincrono senza bloccare gli utenti. È possibile regolare la loro frequenza in base alle esigenze dell’applicazione: eseguirli regolarmente, in batch o attivarli su richiesta, ad esempio dopo una distribuzione o una modifica significativa ai dati.
Un errore non interrompe l’elaborazione: i vettori che non è stato possibile calcolare rimangono in sospeso e vengono riprovati automaticamente durante l’esecuzione successiva.
Ciò consente di trovare il giusto equilibrio tra risultati aggiornati, carico di elaborazione e costi delle API di IA, mentre 4D si occupa degli aspetti tecnici necessari per ricalcolare gli embedding.
Una volta calcolati i vettori, la ricerca semantica si svolge in due fasi.
In primo luogo, si calcola un embedding per il testo inserito dall’utente. Affinché i vettori siano comparabili, l’embedding deve essere calcolato con lo stesso modello dei vettori memorizzati. L’utilizzo della definizione configurata in 4D Embedding Studio garantisce l’impiego di quella corretta.
// Retrieve the embedding definition configured in 4D Embedding Studio
var $settings:=cs.EmbeddingStudio.Settings.new()
var $definition:=$settings.find("Students"; "student_vector")

// Compute the vector of the user's query with the same model
var $result:=cs.EmbeddingStudio.Playground.new().embed("apps that are easy to use"; $definition)
Successivamente, si esegue una query ORDA sul campo vettoriale. 4D confronta in modo nativo il vettore della query con quelli delle entità, mantiene quelli che superano la soglia di similarità e li ordina dal più vicino al più lontano:
// Find the most similar students, best match first
var $students:=ds.Students.query("student_vector > :1 order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Se si utilizza un campo “dirty”, è sufficiente aggiungere un criterio per escludere i vettori in attesa di essere ricalcolati:
var $students:=ds.Students.query("student_vector > :1 and student_vector_dirty = false order by student_vector desc"; \
{vector: $result.vector; threshold: 0.5})
Questa ricerca permette di individuare uno studente la cui biografia menzioni «interfacce intuitive» e «test di usabilità», anche se nessuna di queste parole compare nella query.
Per saperne di più sulla ricerca vettoriale in 4D (metriche di similarità, soglie e combinazione con criteri tradizionali), consulta i nostri articoli precedenti:
Ora che hai tutto ciò che ti serve per iniziare, perché non provi 4D Embedding Studio nella tua applicazione? Per prima cosa, aggiungilo al tuo progetto: apri “Design > Dipendenze del progetto”, fai clic sul pulsante “+” e seleziona la scheda “GitHub”. Scegli “4D Embedding Studio” dall’elenco dei componenti standard 4D, quindi aggiungilo al tuo progetto.
Per impostazione predefinita, la regola di dipendenza è impostata su “Segui versione 4D”, in modo da mantenere il componente allineato alla tua versione di 4D. Riavvia il progetto quando richiesto per caricare il componente.
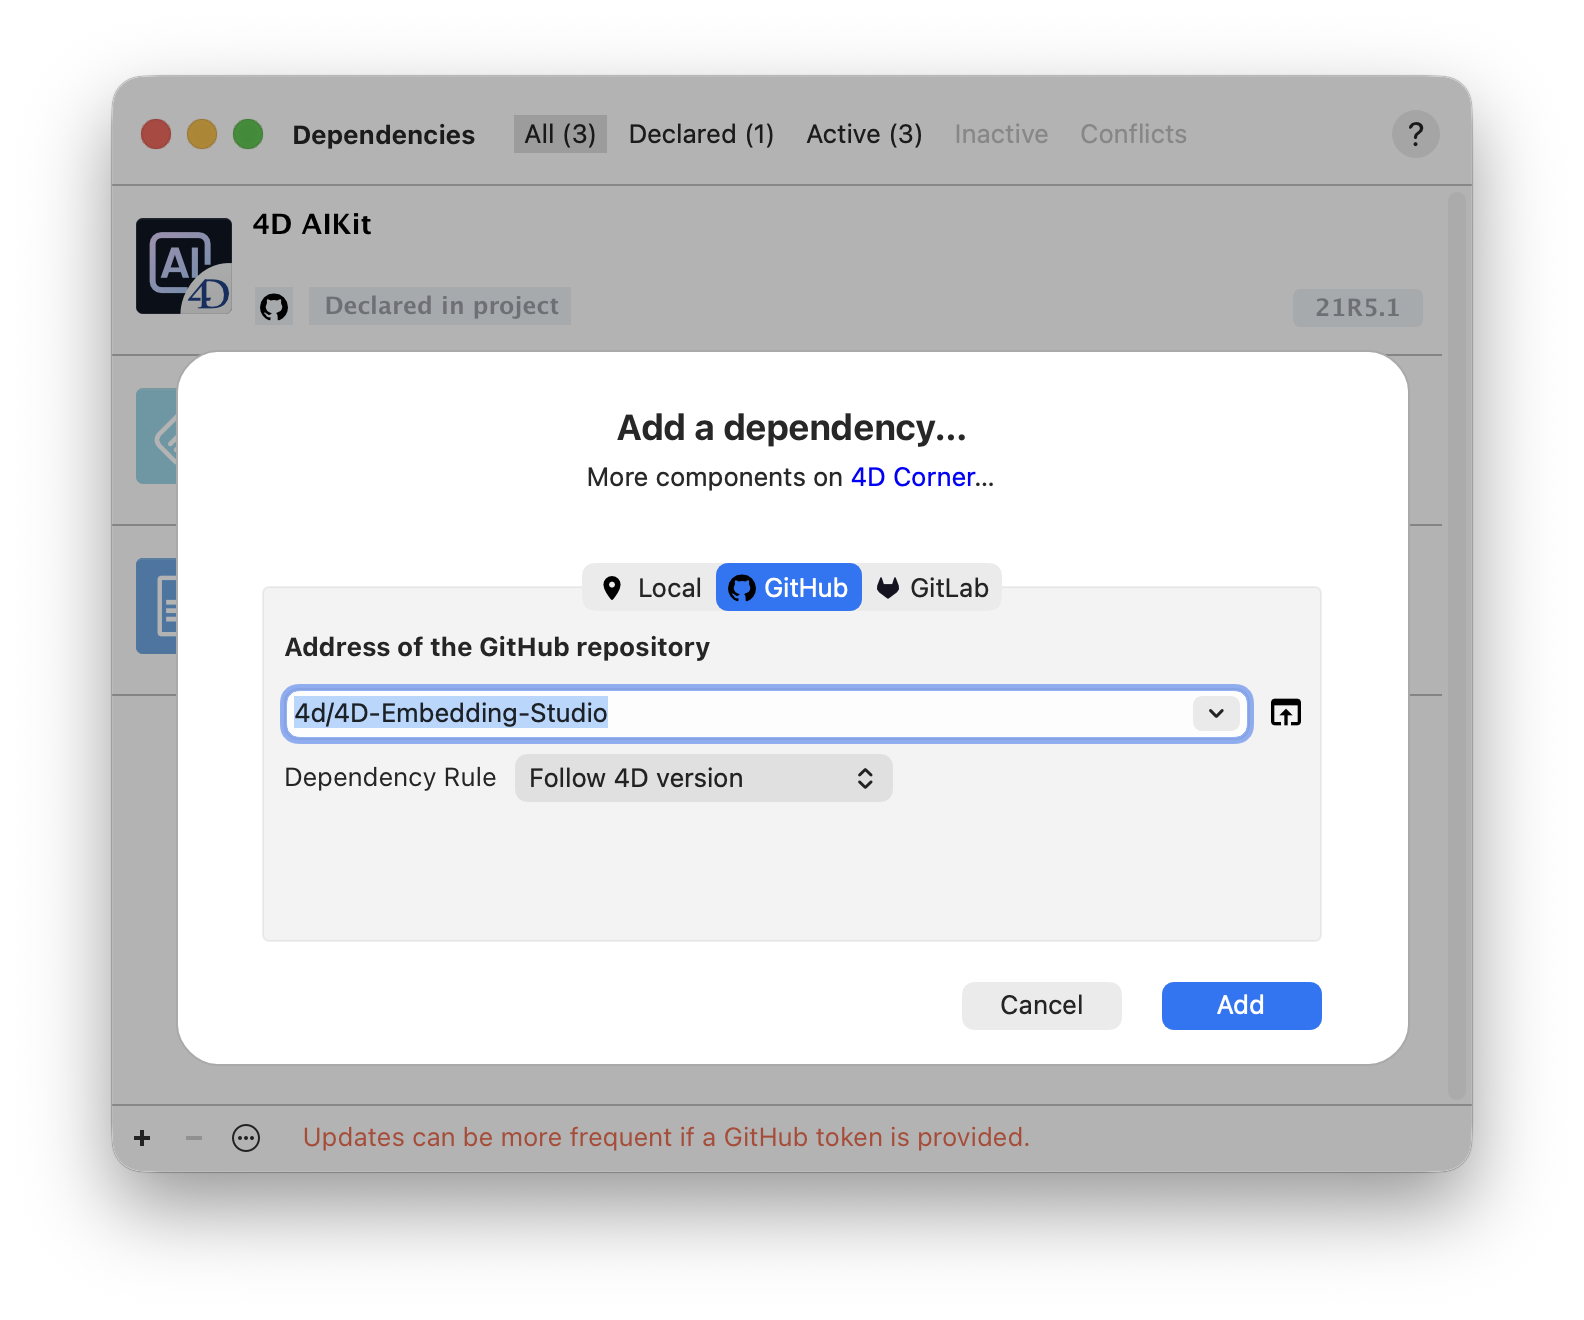
Per ulteriori informazioni, consulta Gestione delle dipendenze di progetto e Gestione dei componenti standard 4D.
Con 4D Embedding Studio, 4D gestisce tutti i meccanismi necessari per il ciclo di vita delle tue integrazioni:
Non è necessario creare o gestire questa infrastruttura: il codice può concentrarsi su ciò che apporta valore all’applicazione, come la ricerca semantica, i consigli o la corrispondenza dei contenuti.
Consulta la documentazione per configurare il tuo primo embedding e scoprire come integrarlo nelle tue ricerche semantiche.
Avete domande, suggerimenti o volete semplicemente entrare in contatto con i blogger di 4D? Lasciateci un messaggio!
* La vostra privacy è molto importante per noi. Fare clic qui per visualizzare il nostro Politica
Al momento non è possibile lasciare commenti su questo post.