
Indicizzazione vettoriale in 4D: ricerca più veloce di similarità per campi vettoriali 4D.Vector
Ottobre 20, 2026
5 Tempo di lettura
I dativettoriali sono alla base delle moderne funzionalità basate sull’intelligenza artificiale: ricerca semantica, motori di raccomandazione, pipeline RAG (Retrieval-Augmented Generation) e altro ancora. Man mano che i campi 4D eVector assumono un ruolo di primo piano nei database 4D, la capacità di indicizzarli in modo efficiente è essenziale per garantire la velocità delle query anche con l’aumentare dei set di dati. Questo articolo illustra come funziona l’indicizzazione vettoriale in 4D, quali algoritmi sono supportati e come gestire gli indici vettoriali a livello di programmazione.
L’esecuzione di una query su un campo vettoriale comporta in genere l’individuazione dei record i cui vettori sono “più vicini” a un vettore di riferimento, utilizzando una metrica di similarità. Senza un indice, 4D deve scansionare ogni vettore della tabella e calcolare la distanza uno per uno, operazione corretta ma lenta man mano che la tabella cresce.
Con un indice vettoriale, 4D utilizza un algoritmo appositamente progettato per la ricerca di similarità vettoriale, riducendo drasticamente il tempo di esecuzione della query pur restituendo gli stessi risultati di una query non indicizzata. In altre parole:
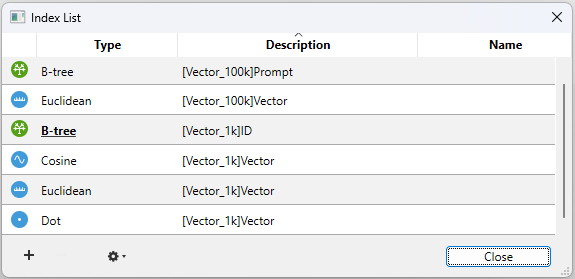
4D introduce tre tipi di indici dedicati per i campi 4D.Vector, oltre all’indice “Standard” già esistente:
| Costante | Caso d’uso |
|---|---|
Indice coseno vettoriale |
Somiglianza basata sull’angolo tra i vettori |
Indice dot vettoriale |
Somiglianza basata sul prodotto scalare |
Indice vettoriale euclideo |
Somiglianza basata sulla distanza in linea retta |
Questi sono disponibili tramite CREATE INDEX e SET INDEX, e ogni tipo di indice può essere selezionato in modo indipendente, consentendo a un singolo campo vettoriale di avere contemporaneamente più indici (ad esempio, sia coseno che euclideo).
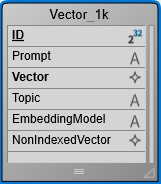
I campi vettoriali e i relativi indici sono completamente integrati nell’Editor di struttura e nelle finestre di dialogo correlate:
 , sia nell’Editor della struttura che nell’Inspector.
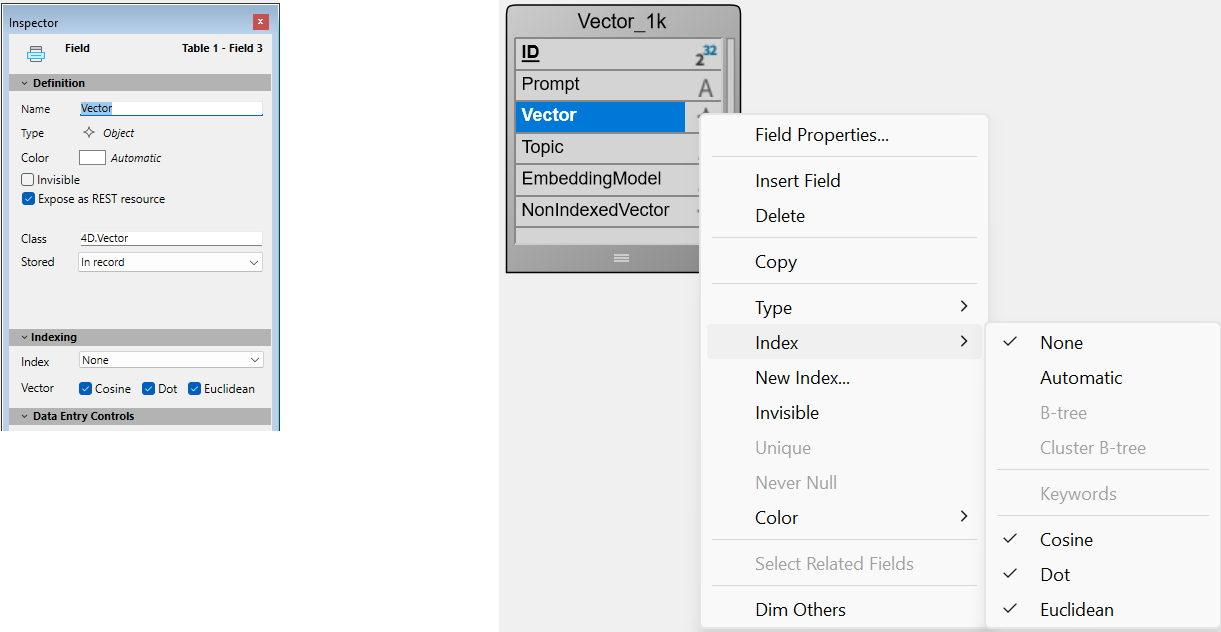
4D si occupa di mantenere gli indici vettoriali coerenti con i dati:
Si tenga presente che:
Gli indici vettoriali sono trattati come elementi di primo piano in tutti gli strumenti di manutenzione e amministrazione di 4D:
4D.Vector.new() ora accetta un parametro di precisione, che può essere di 32 o 64 bit (costantimk single precision e mk double precision ). Per impostazione predefinita, i nuovi vettori vengono creati con una precisione a 32 bit (4 byte per componente). Ciò riduce dello 50% l’ingombro in memoria rispetto ai vettori a 64 bit, pur mantenendo una precisione sufficiente per i calcoli di similarità e distanza; per questo motivo è l’impostazione predefinita consigliata per la maggior parte dei casi d’uso.
$vector32:=4D.Vector.new([1; 2; 3])
// $vector32.precision=32

$vector64:=4D.Vector.new([1; 2; 3]; mk double precision)
// $vector64.precision=64
Nota sulla compatibilità: questa modifica compromette la compatibilità con il codice esistente che si basava sul precedente valore predefinito a 64 bit. Per mantenere la precisione a 64 bit, passare esplicitamente mk double precision.
L’indicizzazione vettoriale in 4D offre prestazioni di livello produttivo per la ricerca di similarità direttamente all’interno del motore del database, senza sacrificare la coerenza o la facilità d’uso. Che si tratti di sviluppare un sistema di raccomandazione, una funzionalità di ricerca semantica o una pipeline RAG, ora è possibile:
Come sempre, le query indicizzate e non indicizzate restituiscono risultati identici; l’indice serve esclusivamente a ottimizzare le prestazioni, senza mai modificare il comportamento del sistema.
Avete domande, suggerimenti o volete semplicemente entrare in contatto con i blogger di 4D? Lasciateci un messaggio!
* La vostra privacy è molto importante per noi. Fare clic qui per visualizzare il nostro Politica
Al momento non è possibile lasciare commenti su questo post.