
getIndexes() を使用したプログラムによる4D インデックスの管理
10月 19, 2026
1 読了時間
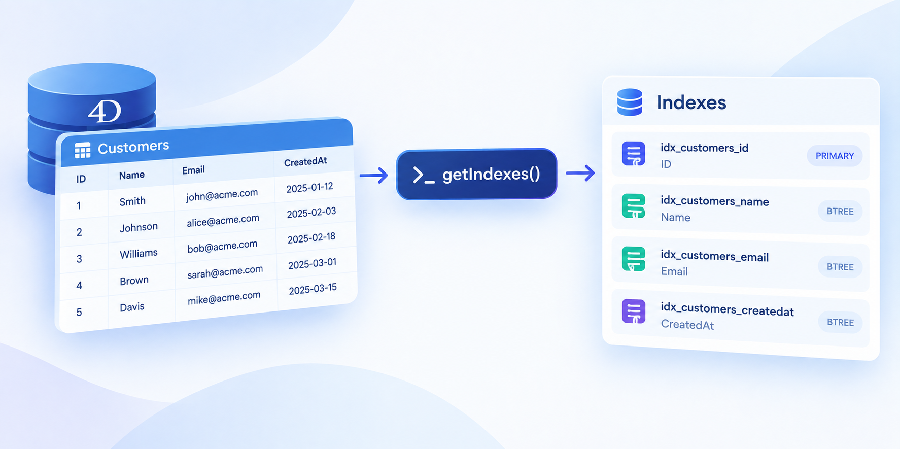
テーブルにどのインデックスが存在し、それらがどのように構成されているかを把握するには、以前は「ストラクチャーエディタ」を使って手動で確認する必要がありました。新しい getIndexes() 関数により、4D 開発者はコードから直接インデックスを検査できるようになり、実行時に構成を簡単に確認したり、診断ツールを構築したり、デプロイメントを自動的に検証したりすることが可能になりました。
4D では、コードから直接インデックスを調査するための新しい関数が追加されました:
var $indexes := ds.MyTable.getIndexes()テーブルに対して getIndexes() を呼び出すと、そのテーブルに定義されているすべてのインデックスを(ストラクチャーエディタで作成されたもの、または CREATE INDEX を使用してコードから作成されたものを問わず)記述したコレクションが返されます。
返されるコレクションの各エントリは、以下の属性を使用してインデックスの詳細を表しています:
| 属性 | 型 | 説明 |
|---|---|---|
type |
整数 | インデックスアルゴリズムのタイプ(「自動」が選択されている場合に適用) |
automatic |
ブール値 | 「自動」インデックスが選択されている場合は True |
name |
テキスト | インデックス名(利用可能な場合) |
kind |
テキスト | "keywords"または"regular" |
attributes |
コレクション | インデックスが対象とするフィールド |
UUID |
テキスト | インデックスの一意の識別子 |
uniqueKey |
ブール値 | インデックスが重複不可を強制するかどうか |
これにより、実行時にフィールドのインデックスの状態を確認することが可能になり、これは特に診断や自動デプロイスクリプトにおいて有用です。
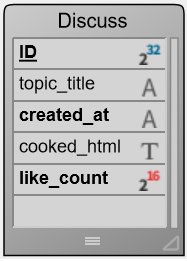
var $indexes:=ds.Discuss.getIndexes()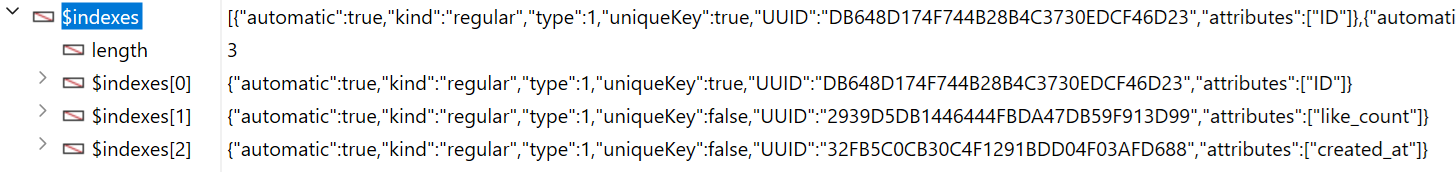
getIndexes() が導入される前は、重要なインデックスが存在するか、あるいは正しいアルゴリズムで設定されているかを確認するには、ストラクチャーエディタを開いて手動でチェックする必要がありました。これは自動化されたワークフローには適していませんでした。この関数を使用すると、以下のことが可能になります:
getIndexes() は、4Dのインデックス管理API における機能の不足を解消します。これにより、開発者はテーブルにどのインデックスが存在するかを確認するために、もはやユーザーインターフェースに頼る必要がなくなります。 CREATE INDEX 、 SET INDEX 、および DELETE INDEX と組み合わせることで、完全にプログラムによるインデックス管理のワークフローが完成します。
現在、この投稿へのコメント機能は利用できません。