
Indexación vectorial en 4D: búsqueda de similitud más rápida para campos vectoriales en 4D
octubre 20, 2026
5 tiempo de lectura
Los datos vectoriales constituyen el núcleo de las funciones modernas basadas en la inteligencia artificial: búsqueda semántica, motores de recomendación, flujos de trabajo RAG (Retrieval-Augmented Generation) y mucho más. A medida que los campos de tipo 4D.Vector pasan a ser elementos fundamentales en las bases de datos 4D, la capacidad de indexarlos de forma eficiente resulta esencial para mantener la rapidez de las consultas a medida que crecen los conjuntos de datos. En esta entrada se explica cómo funciona la indexación vectorial en 4D, qué algoritmos son compatibles y cómo gestionar los índices vectoriales por programación.
Consultar un campo vectorial suele implicar encontrar los registros cuyos vectores sean los «más cercanos» a un vector de referencia, utilizando una métrica de similitud. Sin un índice, 4D tiene que escanear todos los vectores de la tabla y calcular la distancia uno por uno, lo cual es correcto pero lento a medida que la tabla crece.
Con un índice vectorial, 4D utiliza un algoritmo diseñado específicamente para la búsqueda de similitud vectorial, lo que reduce drásticamente el tiempo de consulta al tiempo que devuelve los mismos resultados que una consulta sin indexar. En otras palabras:
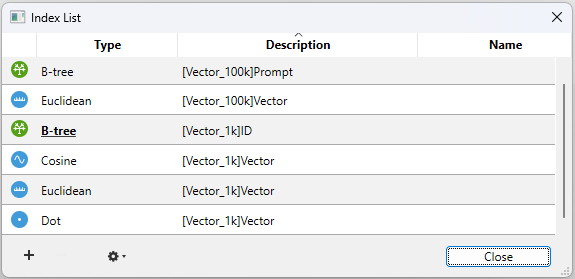
4D introduce tres tipos de índices específicos para los campos 4D.Vector, además del índice «estándar» ya existente:
| Constante | Caso de uso |
|---|---|
Vector cosine index |
Similitud basada en el ángulo entre vectores |
Vector dot index |
Similitud basada en el producto escalar |
Vector euclidean index |
Similitud basada en la distancia en línea recta |
Están disponibles a través de CREATE INDEX y SET INDEX, y cada tipo de índice se puede seleccionar de forma independiente, lo que permite que un mismo campo vectorial tenga varios índices simultáneamente (por ejemplo, tanto el coseno como el euclídeo).
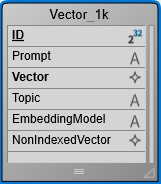
Los campos vectoriales y sus índices están totalmente integrados en el Editor de estructuras y en los cuadros de diálogo relacionados:
 , tanto en el Editor de estructuras como en el Inspector.
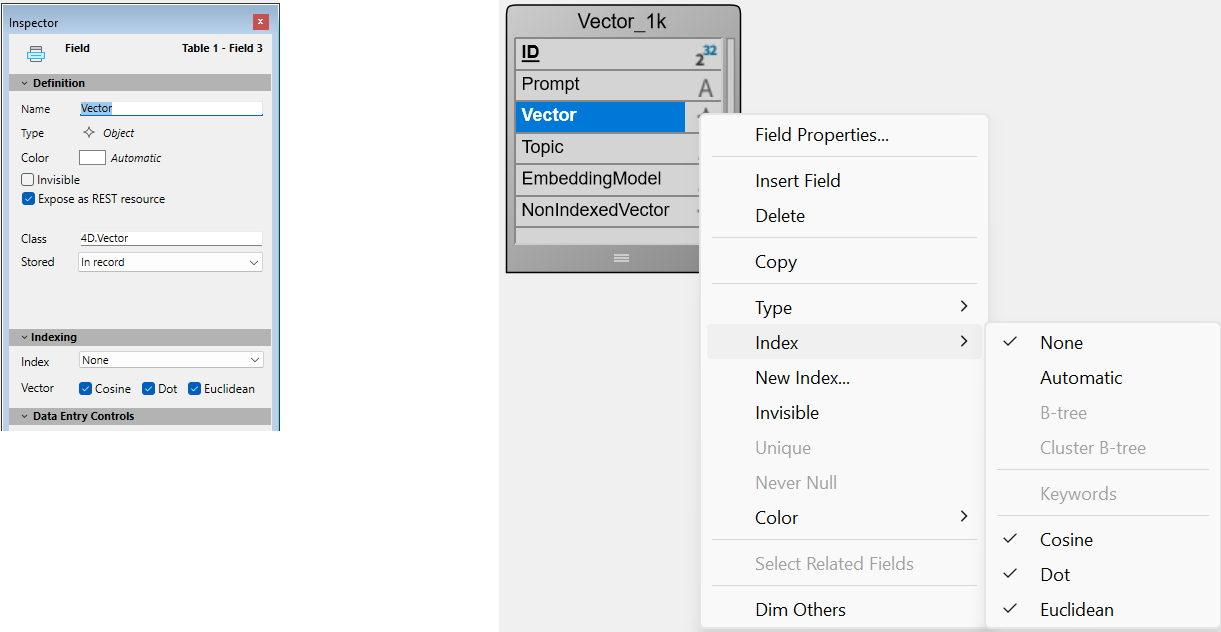
4D se encarga de mantener los índices vectoriales coherentes con los datos:
Tenga en cuenta que:
Los índices vectoriales se tratan como elementos de primer orden en todas las herramientas de mantenimiento y administración de 4D:
4D.Vector.new() ahora admite un parámetro de precisión, que puede ser de 32 o 64 bits (constantes mk single precision y mk double precision). De forma predeterminada, los nuevos vectores se crean con una precisión de 32 bits (4 bytes por componente). Esto reduce el espacio de almacenamiento a la mitad en comparación con los vectores de 64 bits, al tiempo que conserva la precisión suficiente para los cálculos de similitud y distancia, por lo que es el valor predeterminado recomendado para la mayoría de los casos de uso.
$vector32:=4D.Vector.new([1; 2; 3])
// $vector32.precision=32

$vector64:=4D.Vector.new([1; 2; 3]; mk double precision)
// $vector64.precision=64
Nota de compatibilidad: este cambio rompe la compatibilidad con el código existente que se basaba en el valor predeterminado anterior de 64 bits. Para conservar la precisión de 64 bits, se debe pasar explícitamente `mk double precision`.
La indexación vectorial en 4D aporta un rendimiento de nivel de producción a la búsqueda de similitud directamente dentro del motor de la base de datos, sin sacrificar la coherencia ni la facilidad de uso. Tanto si está creando un sistema de recomendaciones, una función de búsqueda semántica o un proceso RAG, ahora puede:
Como siempre, las consultas indexadas y no indexadas devuelven resultados idénticos; el índice es únicamente una optimización del rendimiento, nunca un cambio de comportamiento.
¿Tiene alguna pregunta, sugerencia o simplemente quiere ponerse en contacto con los bloggers de 4D? Escríbenos.
* Su privacidad es muy importante para nosotros. Haga clic aquí para ver nuestra Política
Por el momento, no se pueden publicar comentarios en esta entrada.